从 Foursquare 谢幕聊起:当空间数据每天都在变,AI 到底该怎么用它
这周翻到两条不算旧的新闻。一条是 Foursquare 终于关掉了它起家的那款消费级应用,创始人 Dennis Crowley 写了一封挺伤感的告别信;另一条是前总裁 Steven Rosenblatt 对这家公司十几年得失的复盘。
在我们做地理数据的这个小行当里,Foursquare 算得上祖师爷。十多年前移动互联网刚起步,满世界(咱们大陆有人就用直译的名字——四方,创业了)都在学它的“签到”和“市长”玩法;到了后半场,同行们才慢慢看明白,它真正的本钱不是那个社交软件,而是几亿人用脚投票攒出来的全球门店位置库(Places)。苹果地图、Uber、Twitter 当年都买过它的数据。
一家手里攥着全球物理世界底图的公司,这几年却走得格外艰难:几轮合并,几轮裁员,渐渐淡出了大家的视线。
读完那两篇复盘,我一直在琢磨一个问题:空间位置数据这门生意,为什么总陷进“看着极有价值,用起来差一口气”的怪圈?到了 AI 时代,像极海这样每天都在更新的门店数据,价值到底该怎么放出来?
前辈踩过的坑:卖数据太薄,做软件太重
Foursquare 后期的摇摆,几乎就是我们这个行当过去十年的集体困境。
最早的路是卖原始数据:把采集清洗好的门店名称、经纬度打包成接口或表格卖出去。问题在于,客户买走的是一堆静态字段。我在上一篇文章里提过,没人盯着口径,分析师也好、AI 也好,都很容易把“首次采集日期”当成“实际开业日”。更要命的是,数据一旦交付,对方只关心你一条卖几分钱,没人看得见你为了确认一家店“今天还开不开”,在背后花了多少力气。
为了不沦为卖苦力的管道,Foursquare 后来拼命往软件和广告上转,先后收购了做到店归因的 Placed,合并了做数据的 Factual,又买下做地图可视化的 Unfolded。
收购的公司多了,产品就变得笨重。对大多数企业的业务人员来说,想看一眼竞品分布,得先学一套复杂的 GIS 软件,设十几个筛选条件,再调半天图层颜色。新鲜劲一过,账号就落了灰。
卖表太薄,做软件太重。夹在两者中间,正是数据公司最尴尬的位置。
这两年大家把数据接上大模型,以为一个对话框就能把“软件难用”这件事彻底解决。真接上去才发现,如果只是用自然语言去查一张静态的表,AI 不过是个高级搜索框:容易算错数,也远没把数据的厚度用出来。
经纬度不会变,值钱的是“今天还能不能下单”
要弄清 AI 该怎么用空间数据,得先想明白:我们手里这份数据,最金贵的到底是哪一部分。
很多外行朋友觉得,地理数据嘛,核心不就是经纬度吗?
恰恰相反。一家肯德基或者瑞幸,只要装修好开了门,坐标就钉死在地面上,直到关店都不会变。今天拿到一个静态坐标的成本已经很低了。真正昂贵、而且每天都在折旧的,是这个坐标背后的“状态”。
Foursquare 当年厉害,是因为每天有几百万人在店里打卡,替它确认这家店还活着。后来大家不打卡了,它的状态更新也就慢了下来。
极海走的是另一条路。我们跟踪全国七十多个行业、两万多个连锁品牌,靠的是每天去品牌官网和小程序里巡检。一家店算不算“在营”,最硬的标准是:它的小程序今天还能不能正常点单。
只看今天一天,全国 14,298 家肯德基不过是一张静态分布图;把时间轴拉长、每天看一遍,它就成了线下商业的呼吸和脉搏。
哪家茶饮品牌在华东悄悄关掉了一成门店?哪个零食连锁在过去三个月里,把店密密地铺进了县城中学门口?这些动作往往比上市公司的季度财报早半年就发生了,而绝大多数品牌根本不上市,连财报都没有。
所以,高频空间数据真正的价值不在“空间”本身,而在时间带来的差分(Diff)。单拿一天的数据,是一本电子黄页;把每一天的变化串起来,才是真实的商业情报。
人眼看的是“分布”,AI 读的是“变化”
想通这一点,就能明白为什么过去那些“给人看的网页和报表”,把高频数据的价值埋掉了:人眼天生不擅长看变化。
在我那个demo“全球要素图”上,把上海 1,152 家在营星巴克和 1,912 家在营瑞幸同时画出来,满屏都是密密麻麻的点,看着很密恐。
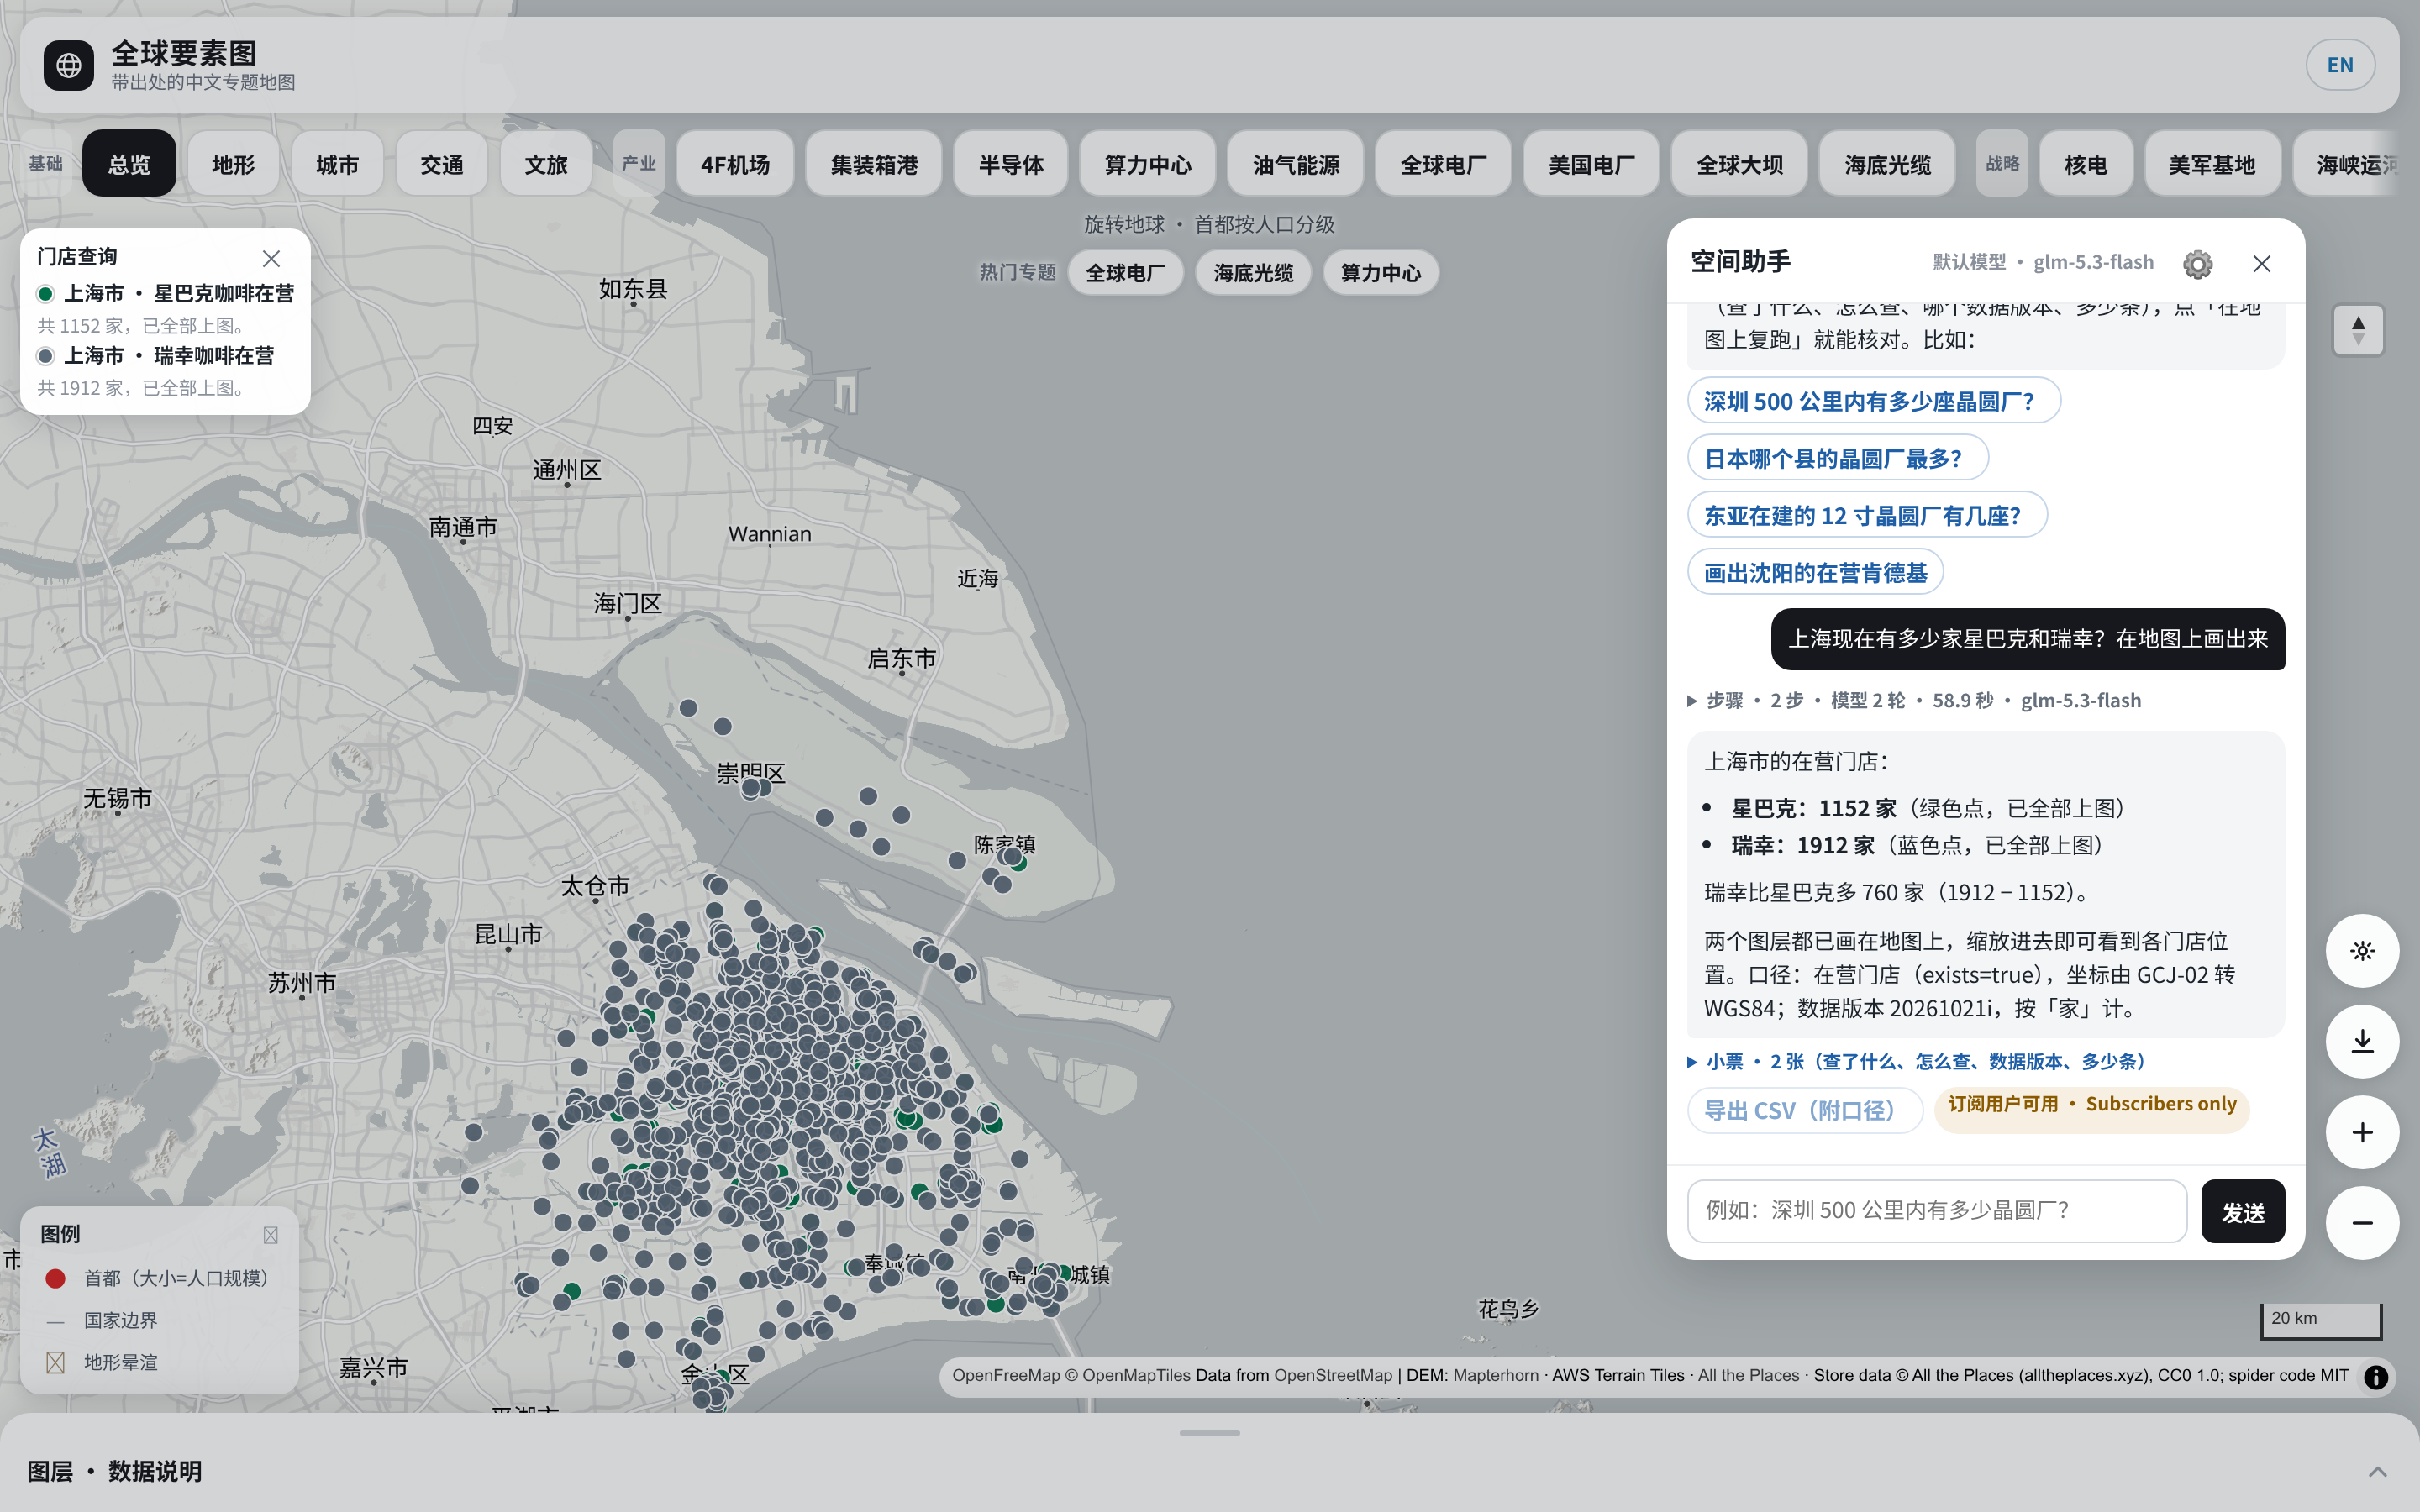
可如果你问一位选址经理:“跟上个月比,这张图上发生了什么?”
Ta只能看傻眼。三千多个点里,肉眼根本分不清哪二十个是新冒出来的,哪十五个是刚消失的。想看懂变化,分析师得把两个月的数据导进 Excel,用公式跑对比,再逐条核对是不是改名、或者小程序临时维护导致的“假关店”。这套流程太繁琐,以至于很多企业买了高频数据,最后还是当成半年才查一次的静态底图在用。
这件事交给 AI,逻辑就顺了。前提是,我们得先替 AI 把“算变化”的工具做好。
接下来的实验里,除了回答“现在有多少家”,我们更想让空间助手直接调用“时间差分工具”。
用户问“过去一个季度,瑞幸在沈阳有哪些新动作”,模型不必把两个时间点的全部门店都拉回来自己比对——那样它几乎一定会算错。工具会在底层直接比对两个数据版本,剔掉因短期装修暂停营业的干扰项,把“净增多少家、新店开在哪几个区、关掉的店周边有什么共同特征”算成确定的数字,连同两个版本的“小票”一起交给模型。
所谓“小票”,就是每个结论背后那张可以核对的凭据:查了哪个图层、用了什么条件、哪个数据版本、一共多少条。下面这张是助手画出沈阳在营肯德基后附上的小票,连“open_date 是监测首次记录,不是开业日”这种口径提醒也一并写在里面。
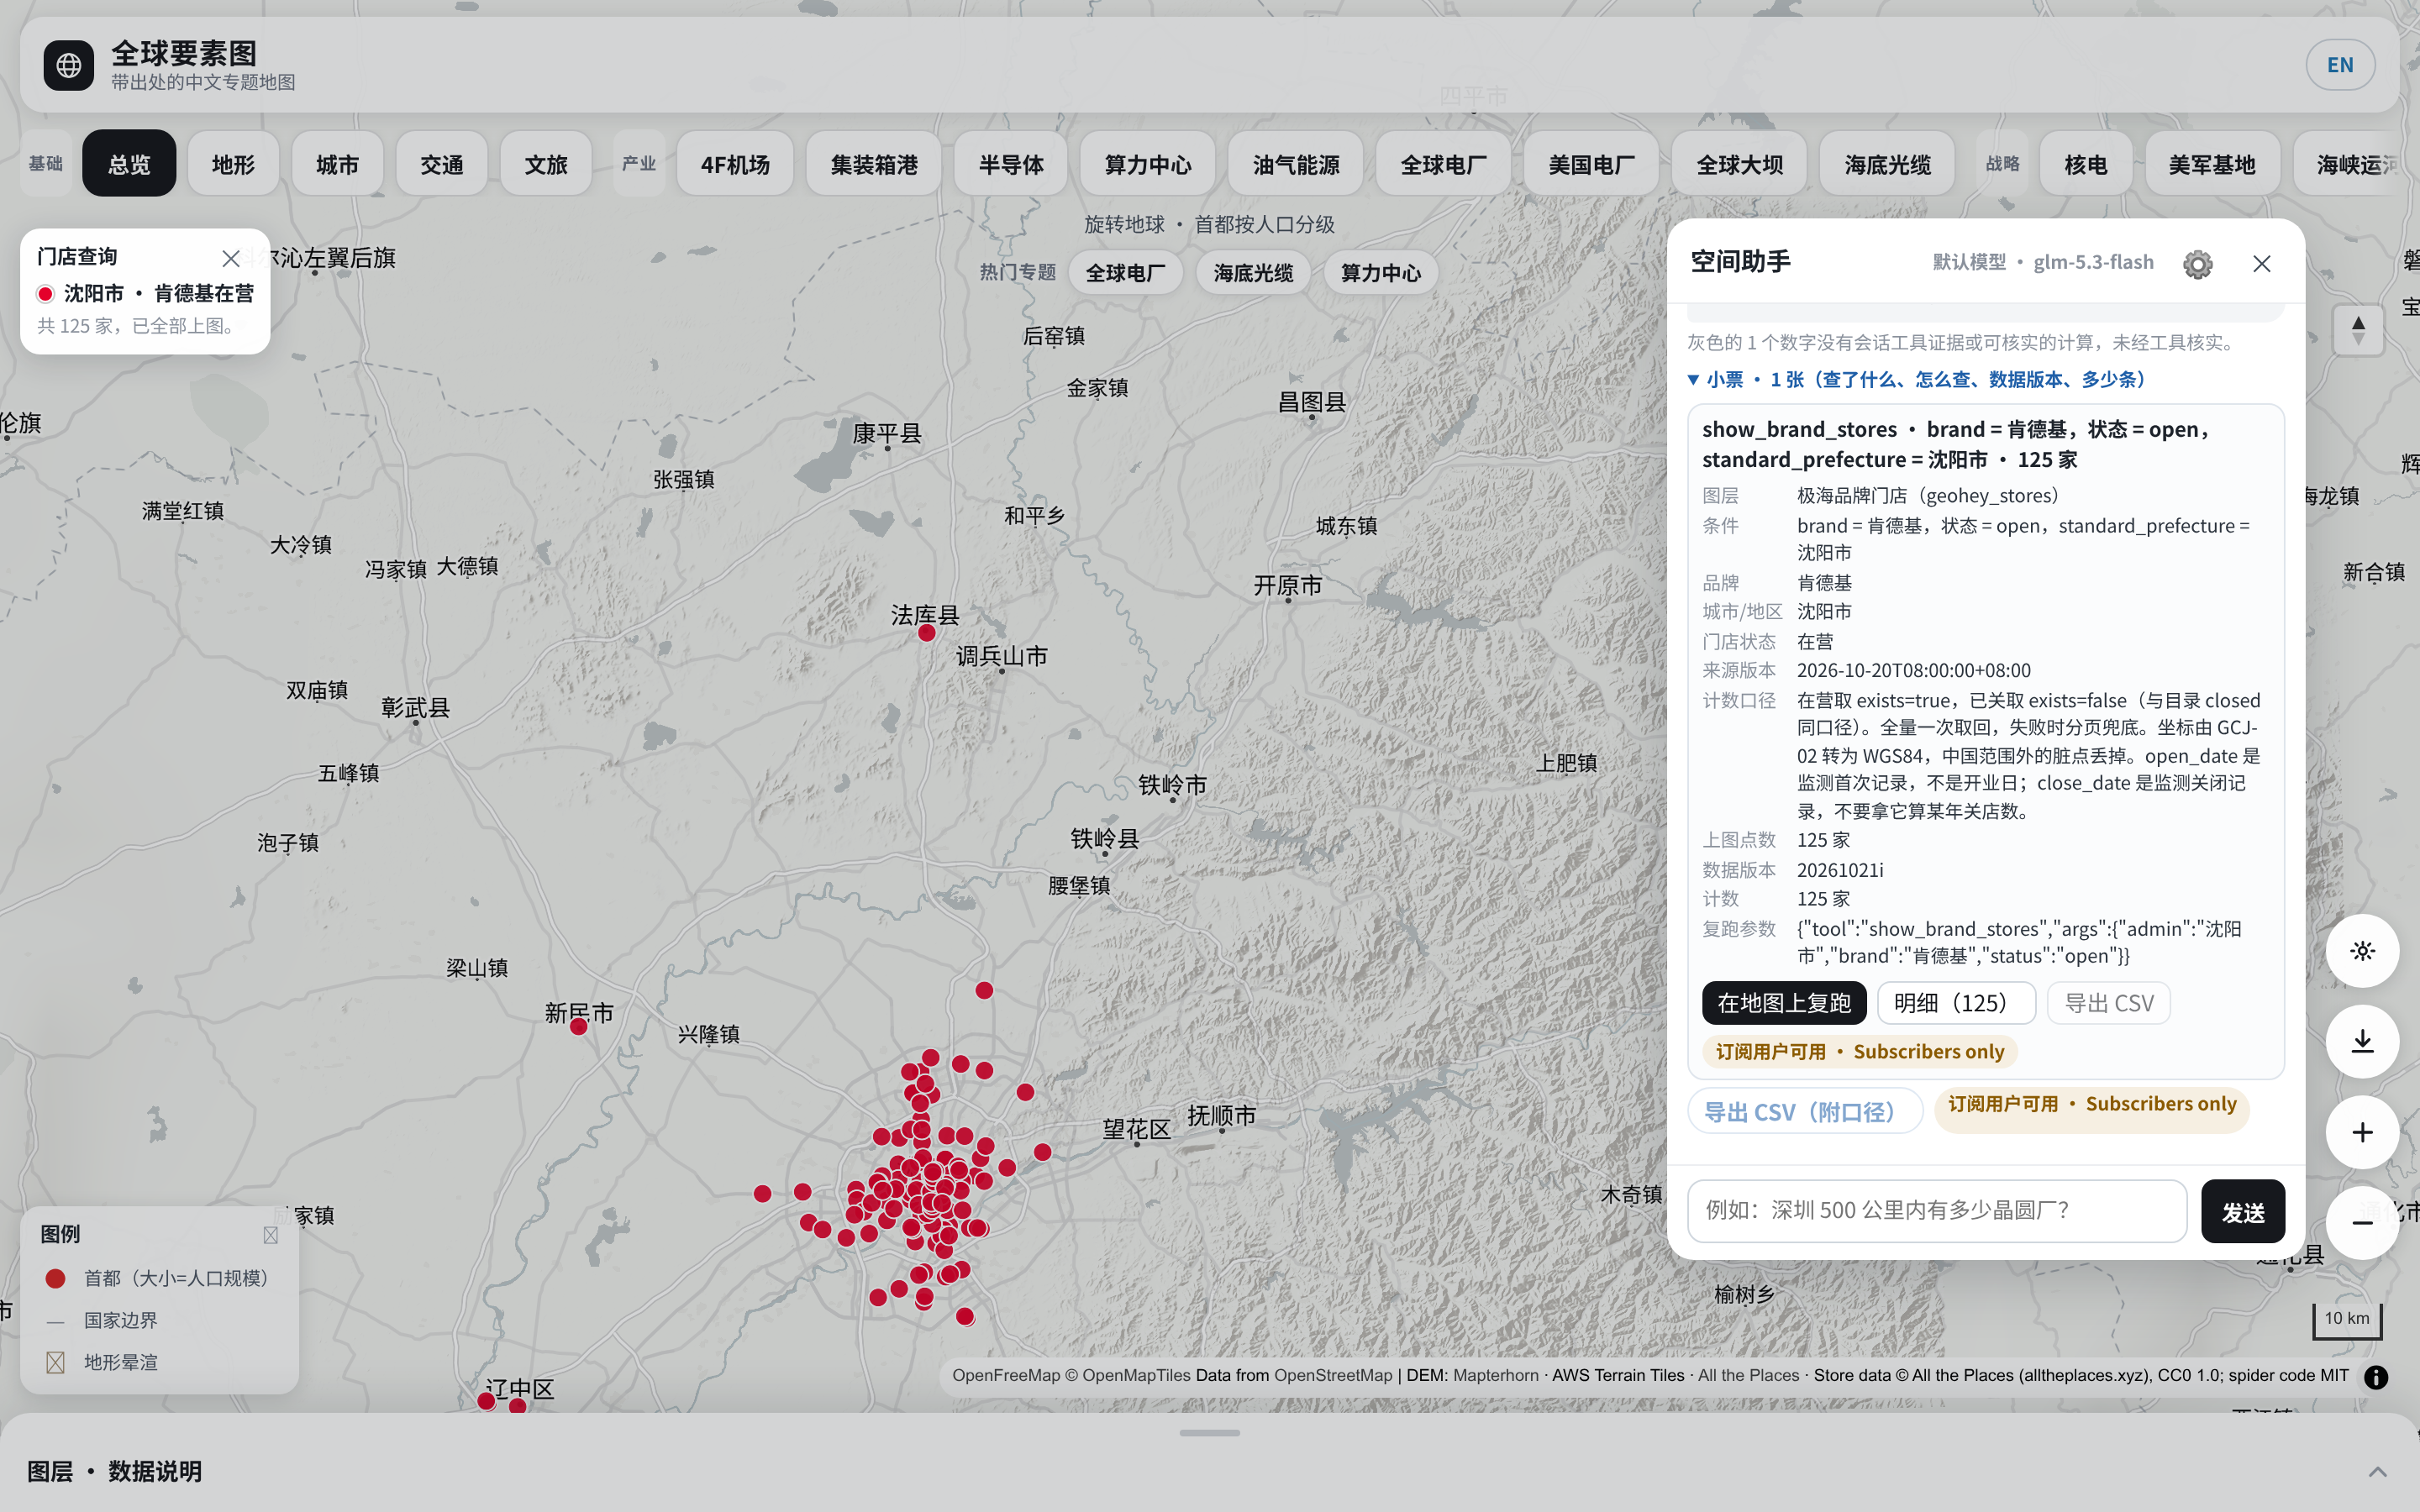
人眼看图,看的是热热闹闹的分布;AI 读数据,读的是一笔一笔的增减。把高频更新带来的“时间差”做成确定性的工具,这份数据才算真正活过来。
三个场景:当数据不再只是“等人来问”
顺着“让 AI 用对高频空间数据”这条路往下走,我觉得至少有三个场景,能把数据的价值真正榨出来。
场景一:从“查单层”到“跨层对账”
企业的财务、供应链、人事数据,平时锁在各自的系统里,没有统一编号,很难凑到一起分析。但只要落到线下,所有商业活动都共享同一个天然主键——物理空间。
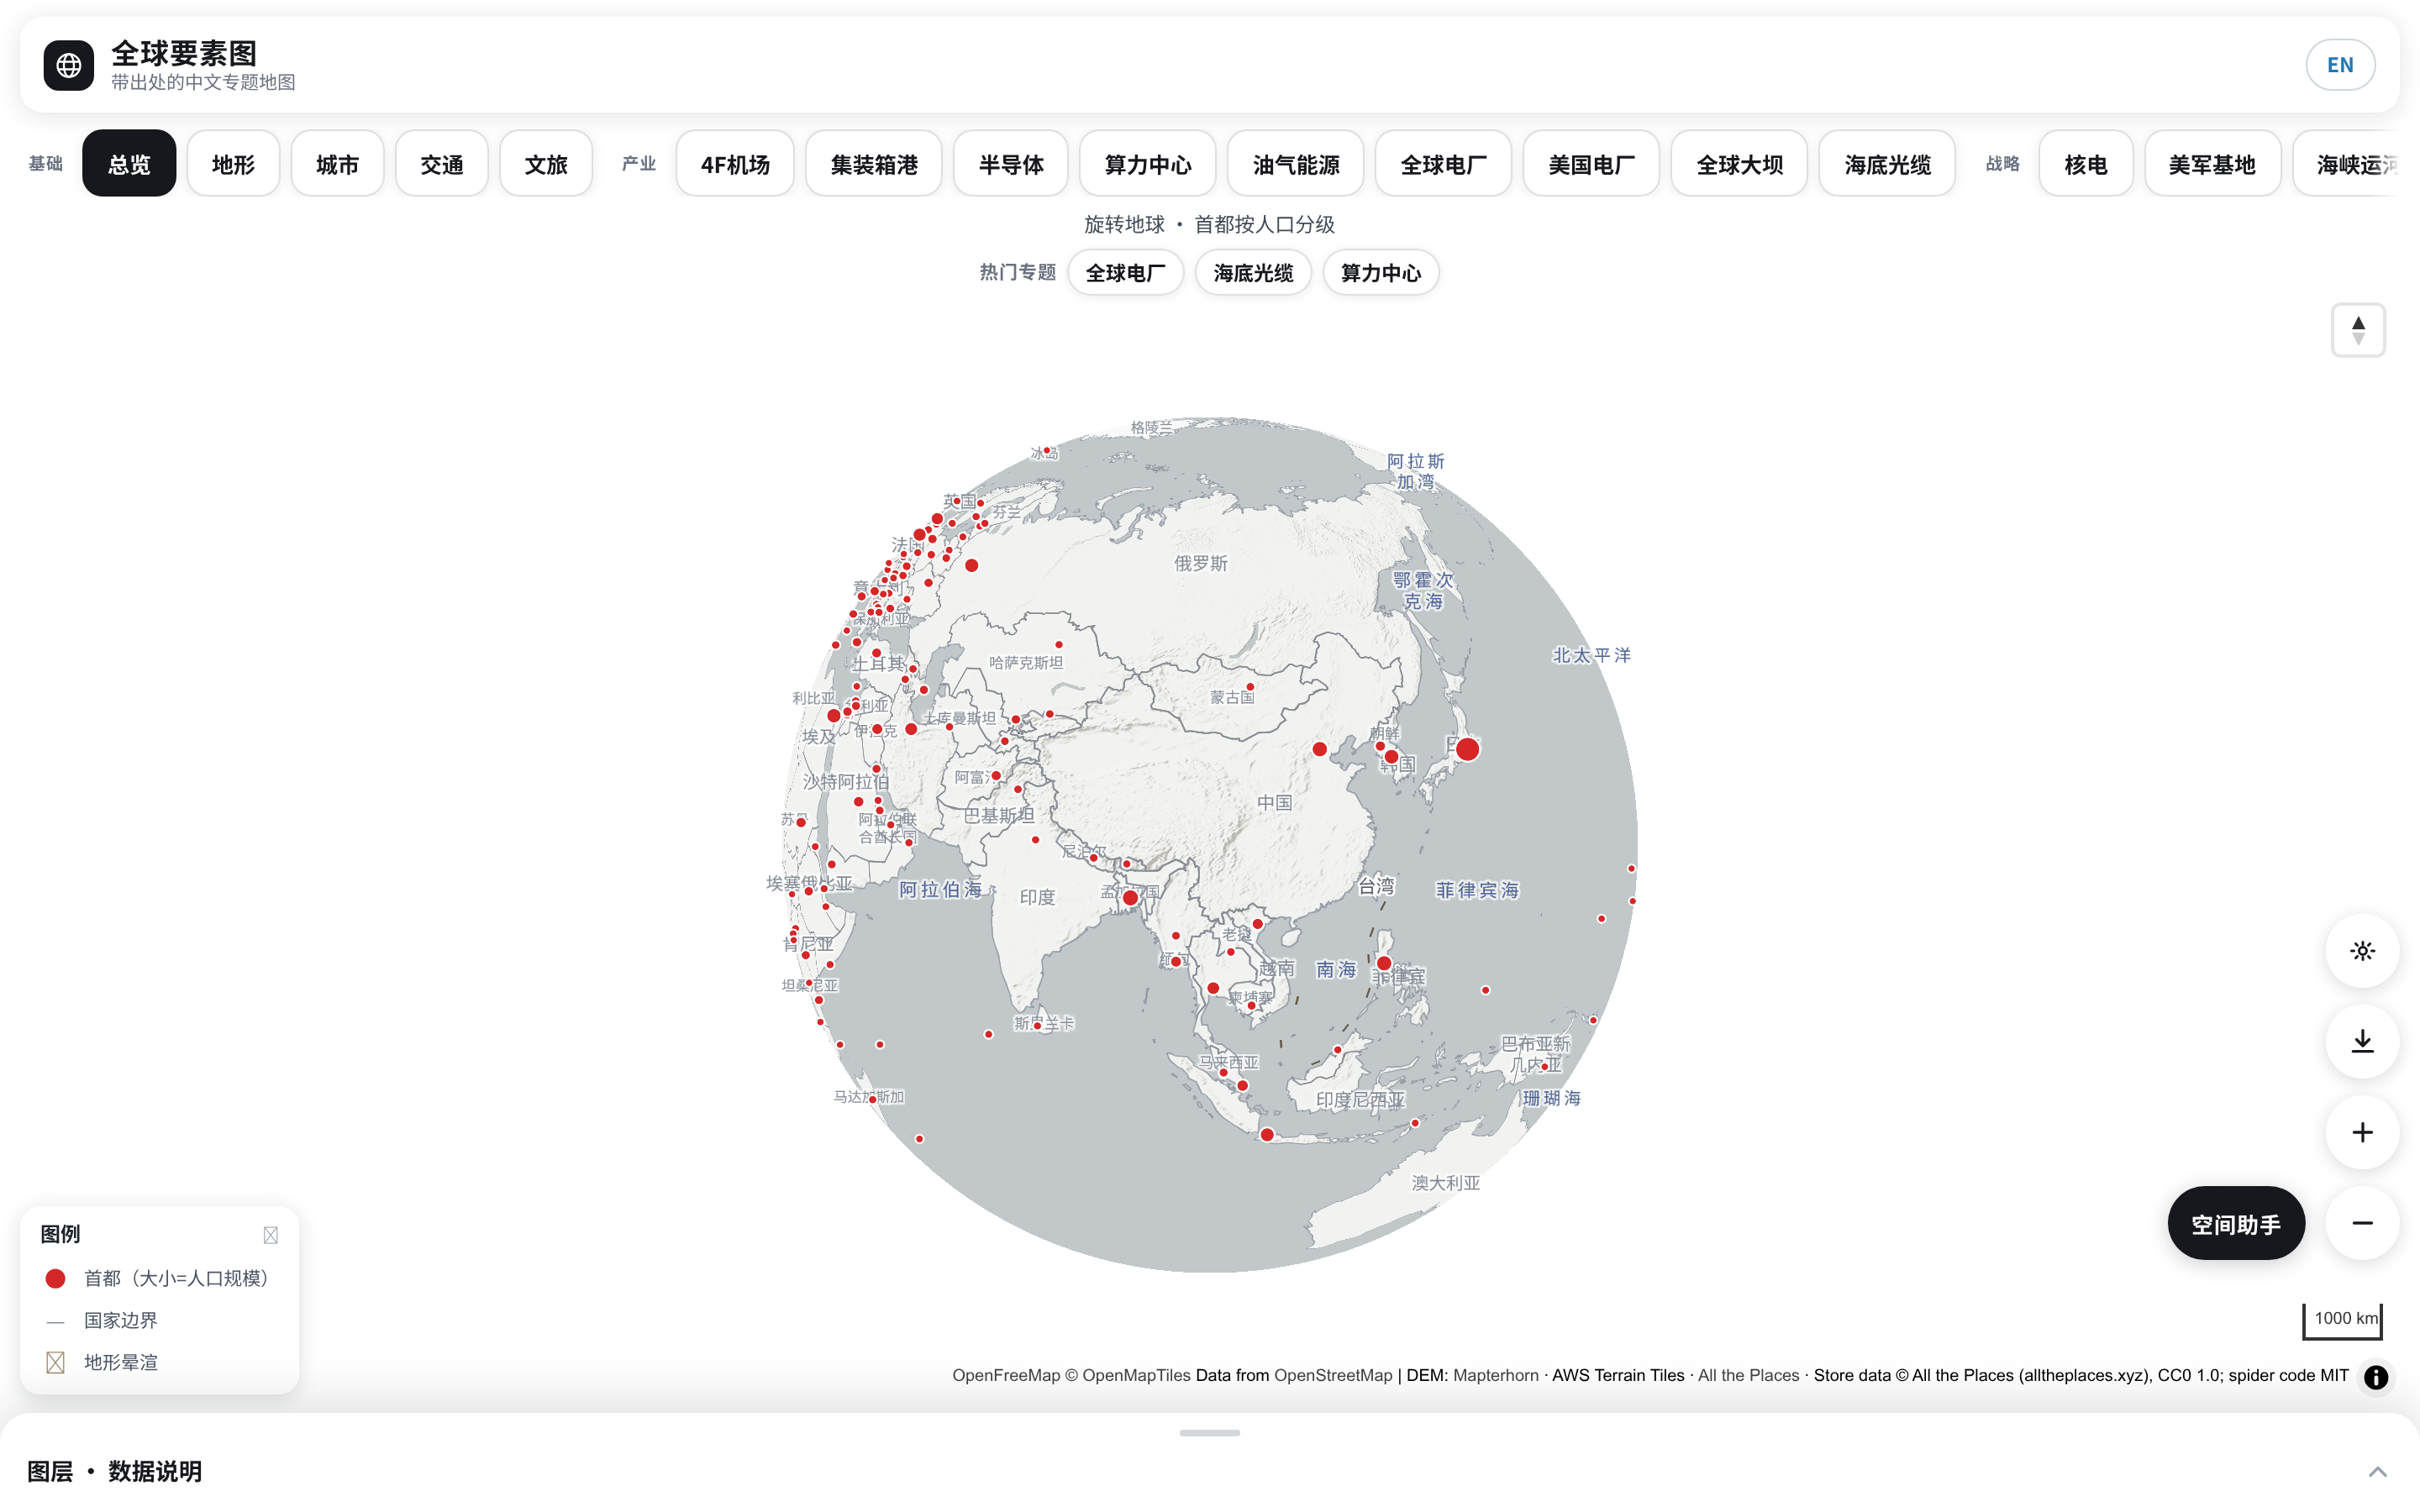
在全球要素图里,我们已经把发电厂、港口、高校和连锁门店放在了同一张底图上。再往前一步,等计算工具支持“空间关联”,你就可以问助手:“开在大学城周边 500 米内的茶饮店,过去半年的闭店率,是不是比写字楼周边的更低?”
单看门店数据,你只知道开和关;把它和周边的用地性质、人口结构,甚至企业自己的客流叠在一起算,事实才会变成洞察。
场景二:从“被动问答”到“空间哨兵”
现在做 AI 助手,默认都是一个输入框:人问一句,AI 答一句。
可高频数据每天都在变,没人能每天早上把全国三百个城市挨个问一遍。既然数据每天都在刷新,为什么不倒过来,让数据的变化去触发 AI?
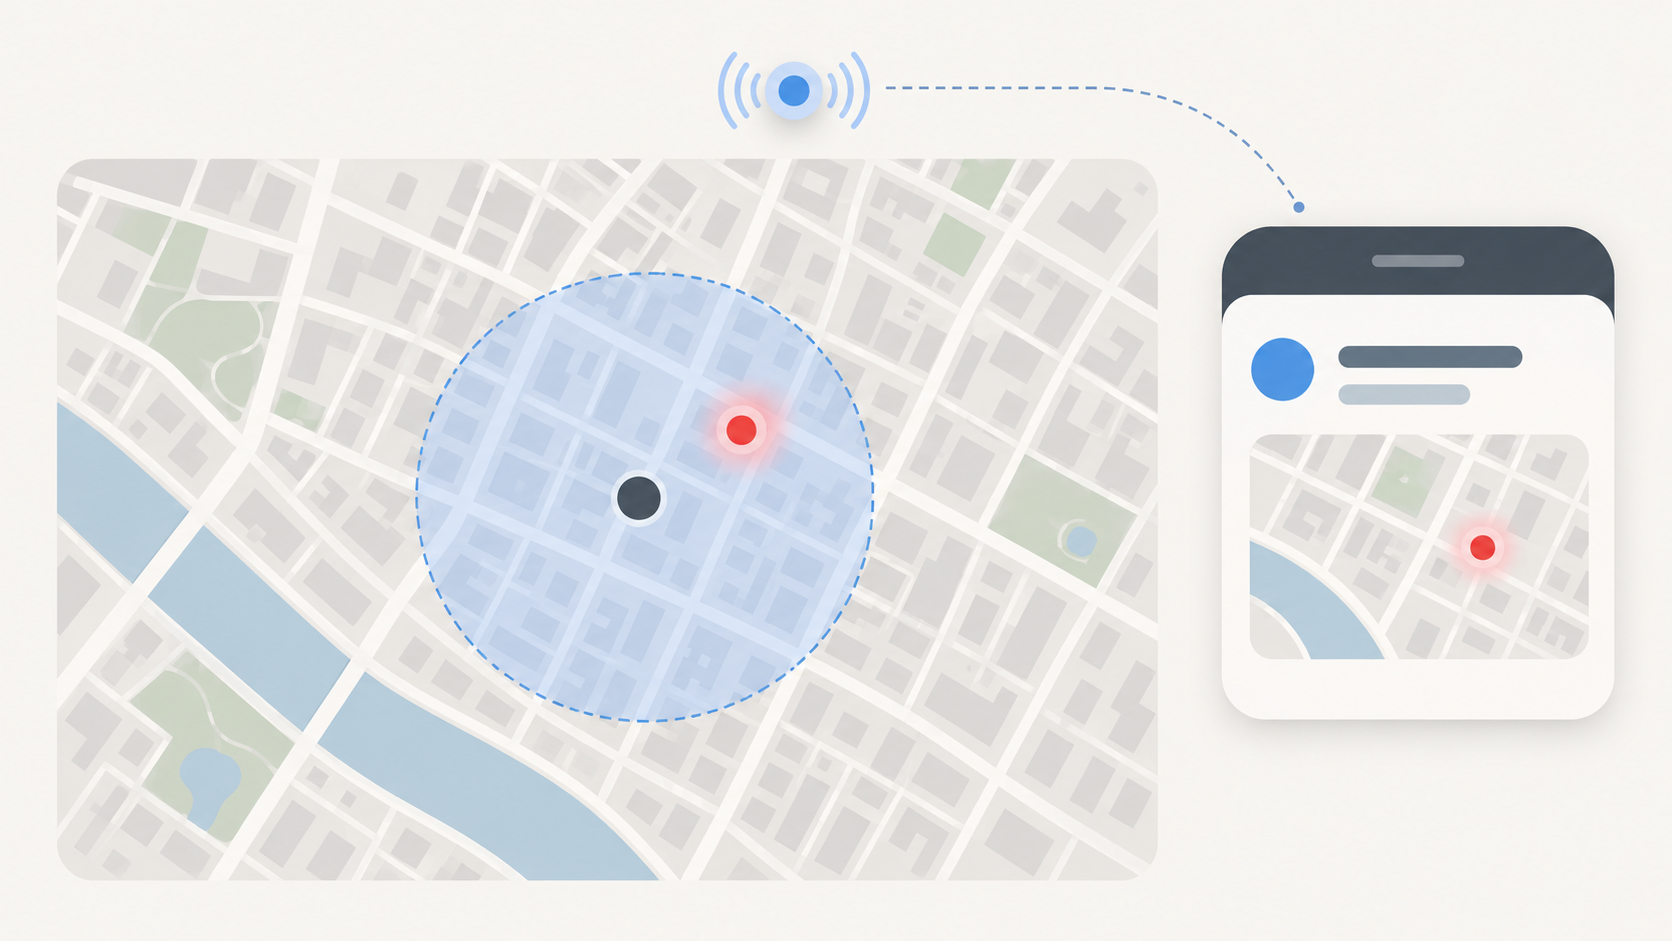
一位管华南区选址的负责人,其实不需要天天跟聊天框对话。Ta只要给助手定一条规矩:“盯住广州这 200 家在营的自有门店。只要任何一家店 500 米内出现竞品新开、可下单的门店,或者同一个商圈里连续有两家餐饮品牌闭店,就把小票和地图截图发给我。”
到这一步,助手就不再是陪聊的问答机器人,而是一个二十四小时趴在数据流上的“哨兵”。每日采集的频率,也才算没有白费。
场景三:带口径的“沙盘推演”
选址和市场规划最怕拍脑袋。过去开会讨论“要不要进某个下沉市场”,往往各执一词。以后在会议室里,也许可以直接让助手拉出三家同行过去一年在该省的开店轨迹和存活周期,再叠上当地常住人口和商业体分布,当场跑出一张带灰色标注、附核验小票的底表。
模型依然不替老板决定开不开店,但它能在五分钟内,把散落各处的硬事实对齐到同一张桌面上,把争论收窄到真正需要人来拍板的业务判断上。
写在最后
回头看 Foursquare 的故事,挺让人唏嘘。Ta用十年证明了物理世界的位置数据是一座金矿,却在“怎么把金矿变成好用的产品”这件事上,绕了很长的弯路。
今天做地理数据的人要幸运一些。我们不必再逼着业务员去学复杂的地图软件,也不用甘心只做底层的卖表人。
只是在把数据交给 AI 之前,那些枯燥的笨功夫一样也省不掉:每天去确认一家店还能不能点单,老老实实写清每个字段的口径,把加减法和空间距离做成不会算错的工具,再给每一个数字附上可追溯的小票。
模型会越来越聪明,但物理世界不会自己变成干净的代码。把真实的线下世界一寸一寸翻译成 AI 不会误解的事实,大概就是我们这个小行当今天最值得干的一件事。