大模型即平台:GIS平台还剩什么?
引子:又有人说缺一个平台
最近参与了一个测绘单位的项目。这个单位的信息化程度不低——地图编制分院已建成自动化制图生产流程,摄影测量与遥感分院具备自主影像解译算法,地理信息分院也部署了智能化数据处理工具,各专业方向的智能化水平均已达到较高程度。
但大领导不满意。他看到的是:各部门各自为政,数据烟囱依旧,智能化没有打通。他的结论是:缺一个平台。像 ArcGIS、超图那样的平台,把所有人拉到同一套体系里。
我认为他的诊断对了一半。烟囱是真的,但这么开药方,可能不与时俱进了。
部门之间的数据不通,根源是管理制度和协作意愿,不是缺一个技术底座。过去二十年,无数单位上了 ArcGIS 或超图,烟囱该在的还在。平台能逼所有人用同一套软件,但逼不出协作——它靠锁定实现对齐,不是靠打通。
更关键的是:在大模型时代,"选一个 GIS 平台作为全组织基础设施"这件事本身就在失去意义。 平台过去卖的核心能力——知识封装、分析工具箱、SDK、制图引擎——正在被大模型逐条接管。每个人都可以用自然语言按需生成工具,不再需要全组织对齐到同一套 SDK 上。
今天的有感而发想说清楚三件事:GIS 平台过去到底在卖什么,大模型拿走了哪些,以及剩下的部分应该怎么花钱。
一、GIS 平台过去在卖什么
回顾一下,ArcGIS、超图这类平台的经典价值大致六层:
- 1. 数据基础设施:空间数据库、空间索引、坐标系管理,把散乱的地理数据组织起来,跨应用共享。
- 2. SDK 与二次开发:ArcObjects、ArcPy、iObjects——平台提供积木,开发者在上面盖房子。
- 3. 分析算法引擎:缓冲区、叠加、网络分析、地统计、栅格代数,几千个工具封进工具箱。
- 4. 制图与渲染引擎:符号系统、标注引擎、排版出图,把数据变成图。
- 5. 格式互操作:读写成百上千种数据格式,充当行业的通用翻译官。
- 6. 企业级服务与生态:服务发布、权限、多用户编辑,外加培训、认证、插件市场构成的职业生态。
但这里有个容易被忽略的事实:今天几乎所有 GIS 软件,底层站的是同一批开源库——GEOS 做几何运算,GDAL 做格式,PROJ 做投影(ArcGIS年岁久,都有自己的库)。商业平台真正卖出的从来不是算法本身,而是把知识、流程和治理封装成一个可交付产品。你不会做近邻分析没关系,平台会;你不懂投影没关系,平台替你管。
对那个测绘单位来说,领导想买的其实就是这层封装——一个让所有部门说同一种语言的东西。但这种"公共语言"的代价是:所有人被锁进同一个平台的术语、流程和许可证体系里。
二、大模型拿走了哪些
对照上面的清单,大模型正在接管其中最核心的三层:
知识不再锁在平台里。 投影、拓扑、空间连接、UTM 分带、栅格代数——模型受过完整的 GIS/RS 训练,这些知识过去藏在平台文档和培训认证里,现在随问随答。一个测绘单位的新人不需要先学三个月超图才能上手,他可以直接问模型。
工具从"预置的功能"变成"按需生成的代码"。 要近邻分析,模型不去工具箱里翻,而是直接写出一次性的空间连接脚本;要地形底图,它自己把 DEM 换成晕渲、重投影、裁剪。工具用完即走,不需要安装、不需要许可证、不需要全组织统一版本。
自然语言即 SDK。 二次开发的接口从函数签名变成了意图。「把北京在业的星巴克和瑞幸拉下来,看它们怎么互相嵌套」——这句话本身就是程序。每个部门可以用自己熟悉的方式提需求,不需要对齐到同一套开发框架。
值得说清楚的是:这不是「又一个软件替代了旧软件」。大模型不是 GIS 软件的竞品,它替代的是 GIS 软件那种封装逻辑——把专业知识锁进重型软件、再通过许可证和培训体系分发的逻辑。
三、平台还剩什么值得花钱
当分析、制图、开发都被模型吸收之后,平台真正不可替代的只剩三件事:
- 1. 数据运维:数据从哪来、有多新鲜、质量如何、版本怎么管。模型再强,也不能凭空长出 2026 年 9 月的门店台账或最新的遥感影像。
- 2. 鉴权与凭证:Token、权限、配额、计费。谁有权读什么,这是治理问题,不是智能问题。
- 3. 对 agent 友好的 API 契约:返回结构稳定吗?参数语义明确吗?那些人类能忍、agent 一定会踩的坑(比如静默忽略未知参数)填了吗?
第三条值得展开一句。我用的极海图层 API 附了一份写给 AI 看的《AI 消费指南》,把已知的静默失败逐条列出——比如字段名拼错不报错而是返回全表,品牌名写「星巴克」而不是「星巴克咖啡」命中 0 行,到了瓦片层表现为整片 404,极容易被误判成服务端故障。人类能忍的静默失败,agent 一定会踩。 这才是数据平台在 agent 时代该做的产品工作——不再经营「给人用的界面」,而是经营「给模型消费的契约」。
回到那个测绘单位的语境:如果领导要花钱,与其买一个 GIS 平台让所有部门对齐到同一套 SDK,不如把钱花在这三件事上——把各部门的数据资产理清楚、把 API 契约写明白、把权限体系建好。这些做好了,每个部门用什么工具、什么语言、什么模型都无所谓,因为它们消费的是同一套数据服务,而不是同一个平台。
四、一个不需要平台的完整分析
说到这里可能还是抽象。下面用两个实验来展示:过去必须在 GIS 平台里做的事,现在可以完全在平台之外完成——而且质量不打折。
实验一:Mac 启动器里的品牌监测
我用几十分钟做了brand-pulse(品牌脉搏),这 是个 Raycast 扩展,嵌在 Mac 的启动器里——一个“毫不 GIS” 的环境。把自然语言问题交给模型,翻译成查询计划,调图层 API,用地图和简报呈现结果。
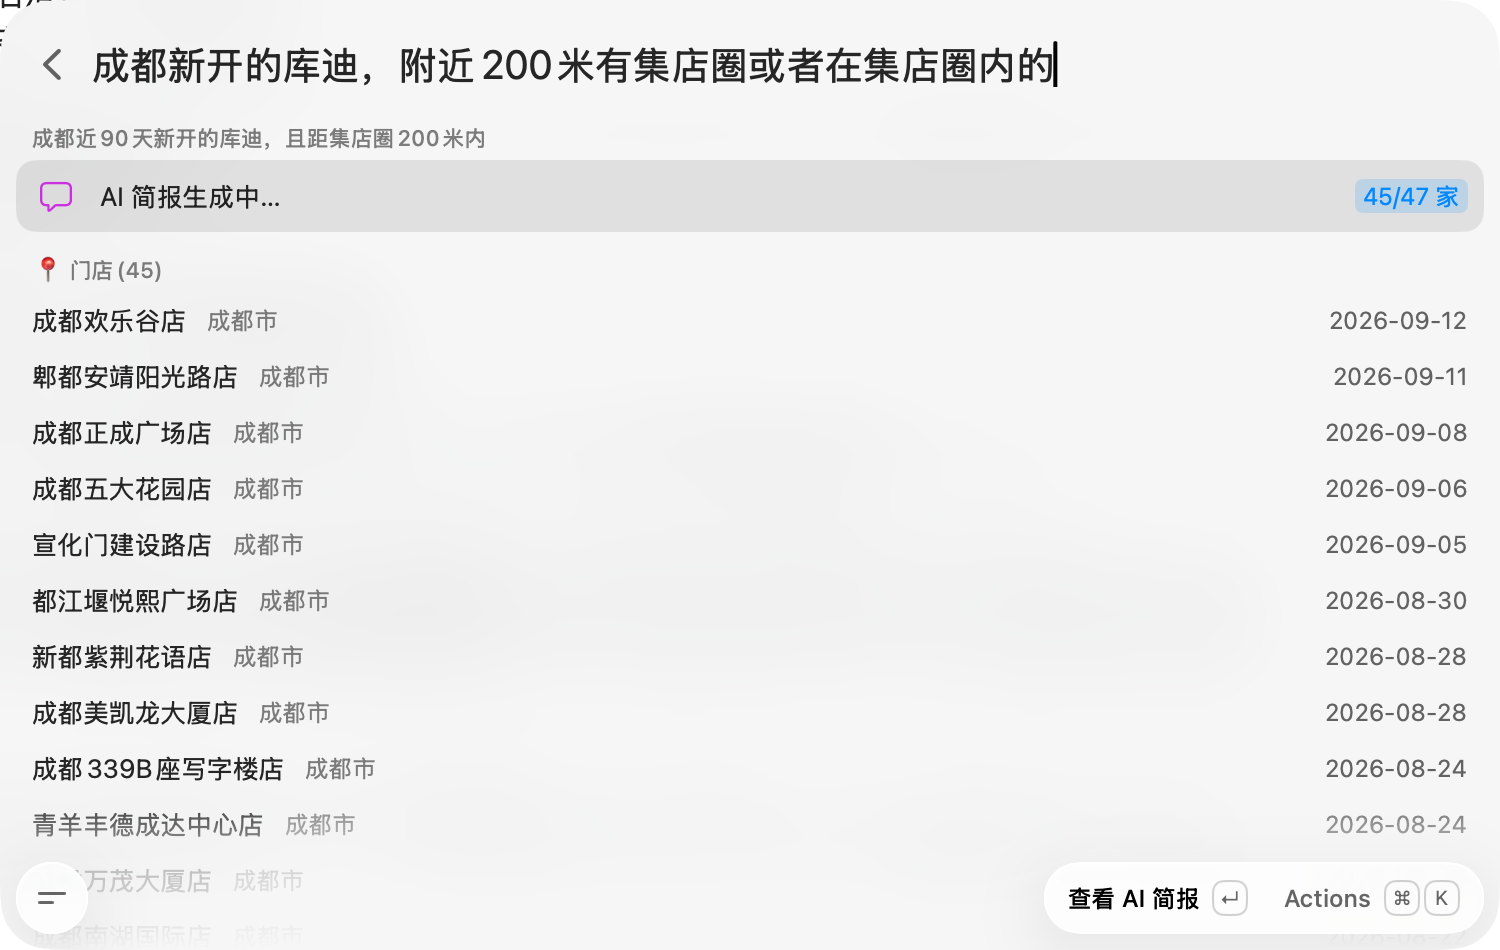
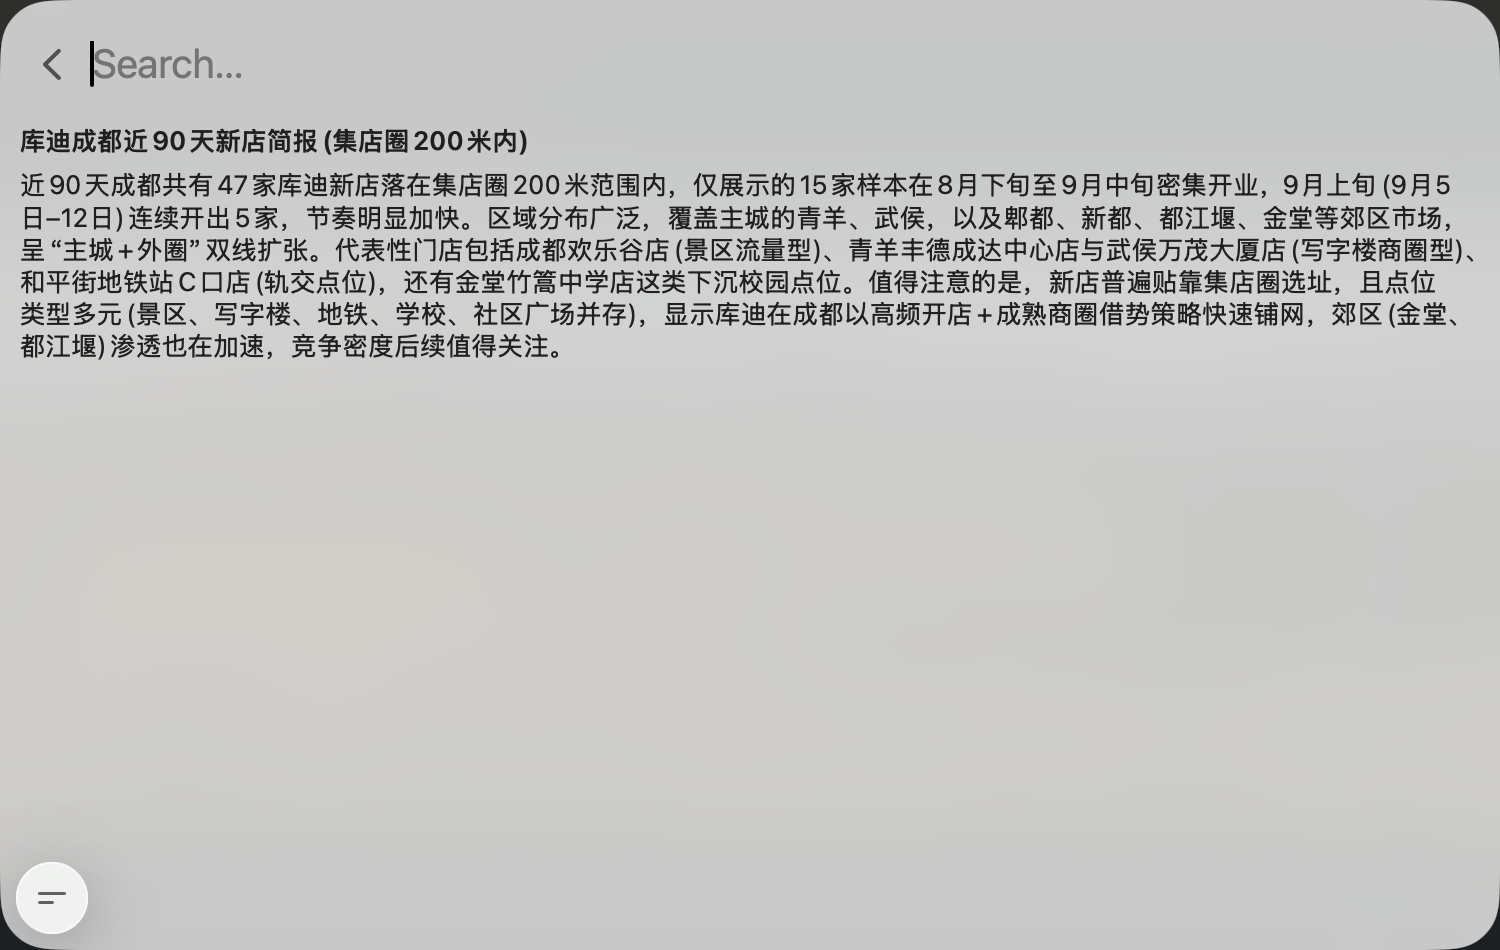
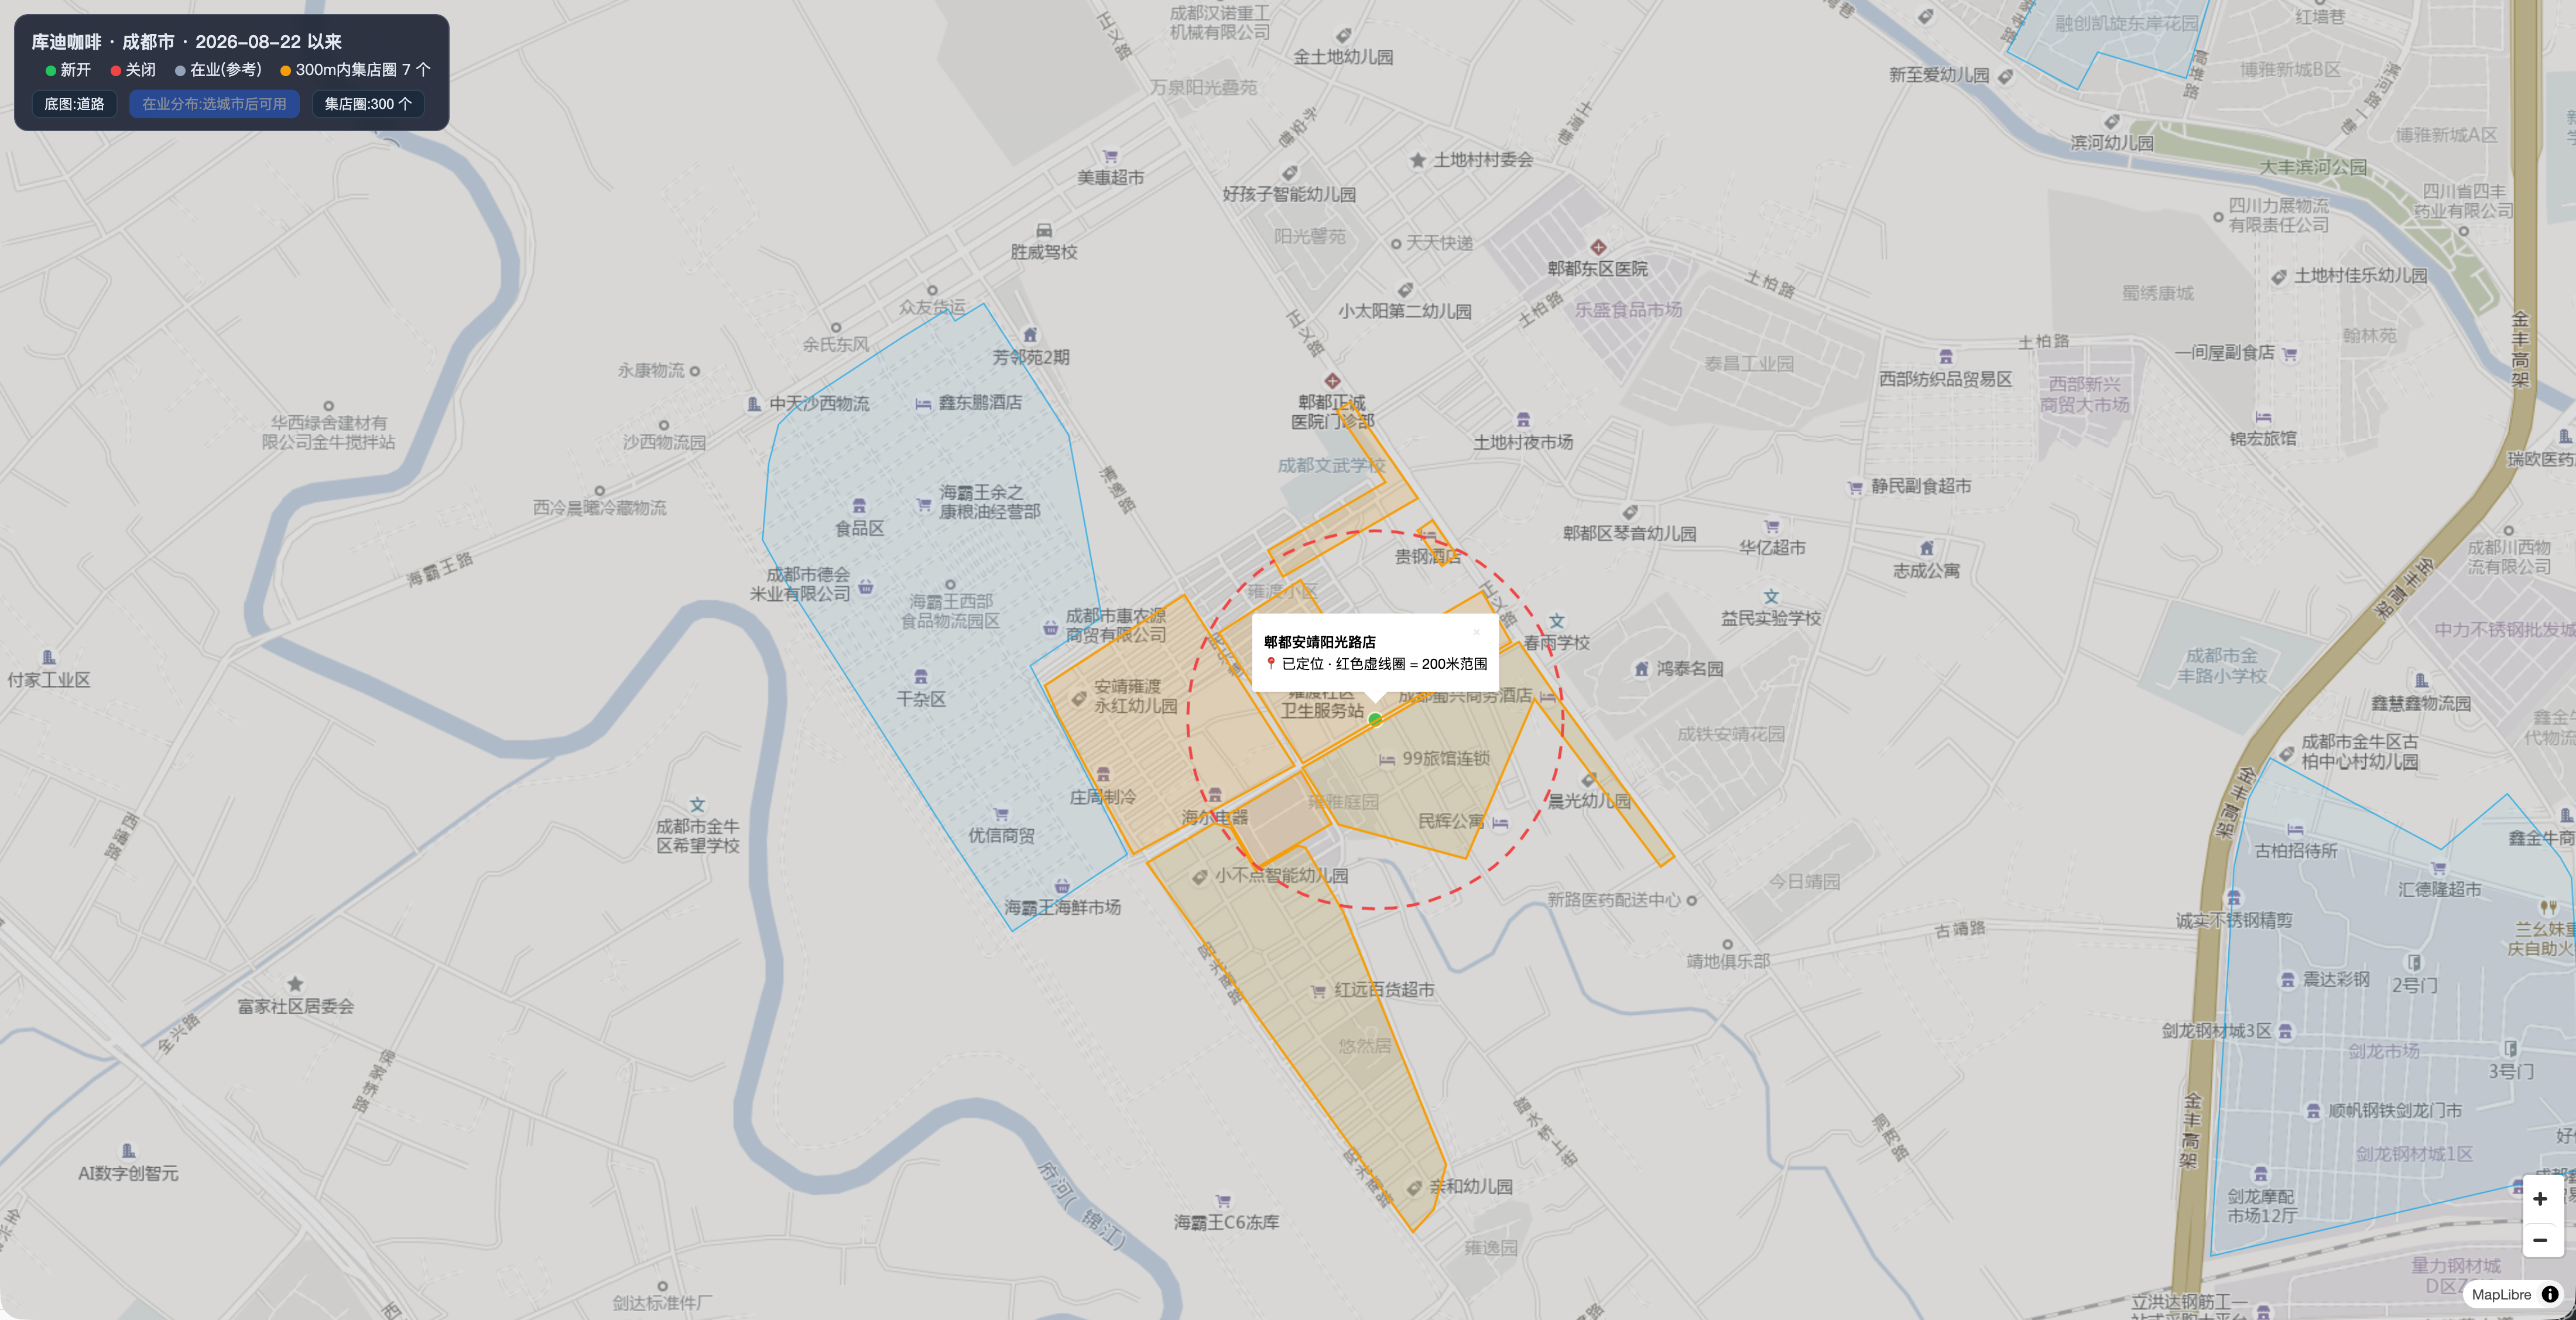
它的意义不在功能,而在形态:专业地理数据变成了日常工具的一个普通能力,中间没有平台客户端、没有工程文件、没有SDK依赖、没有图层树、没有按钮。过去这得在 ArcGIS 里开个项目才能做。
实验二:Jupyter + R 的八张图
第二个实验更硬核。在 JupyterLab 里让大模型对话一个门店数据 API,完成了从取数到路网分析的全链路,产出八张可以复算的地图。整个过程没有打开任何 GIS 软件。
以下每张图旁边标注了它替代的平台能力。
地理语境图——替代:底图管理、DEM 渲染、多图层叠加
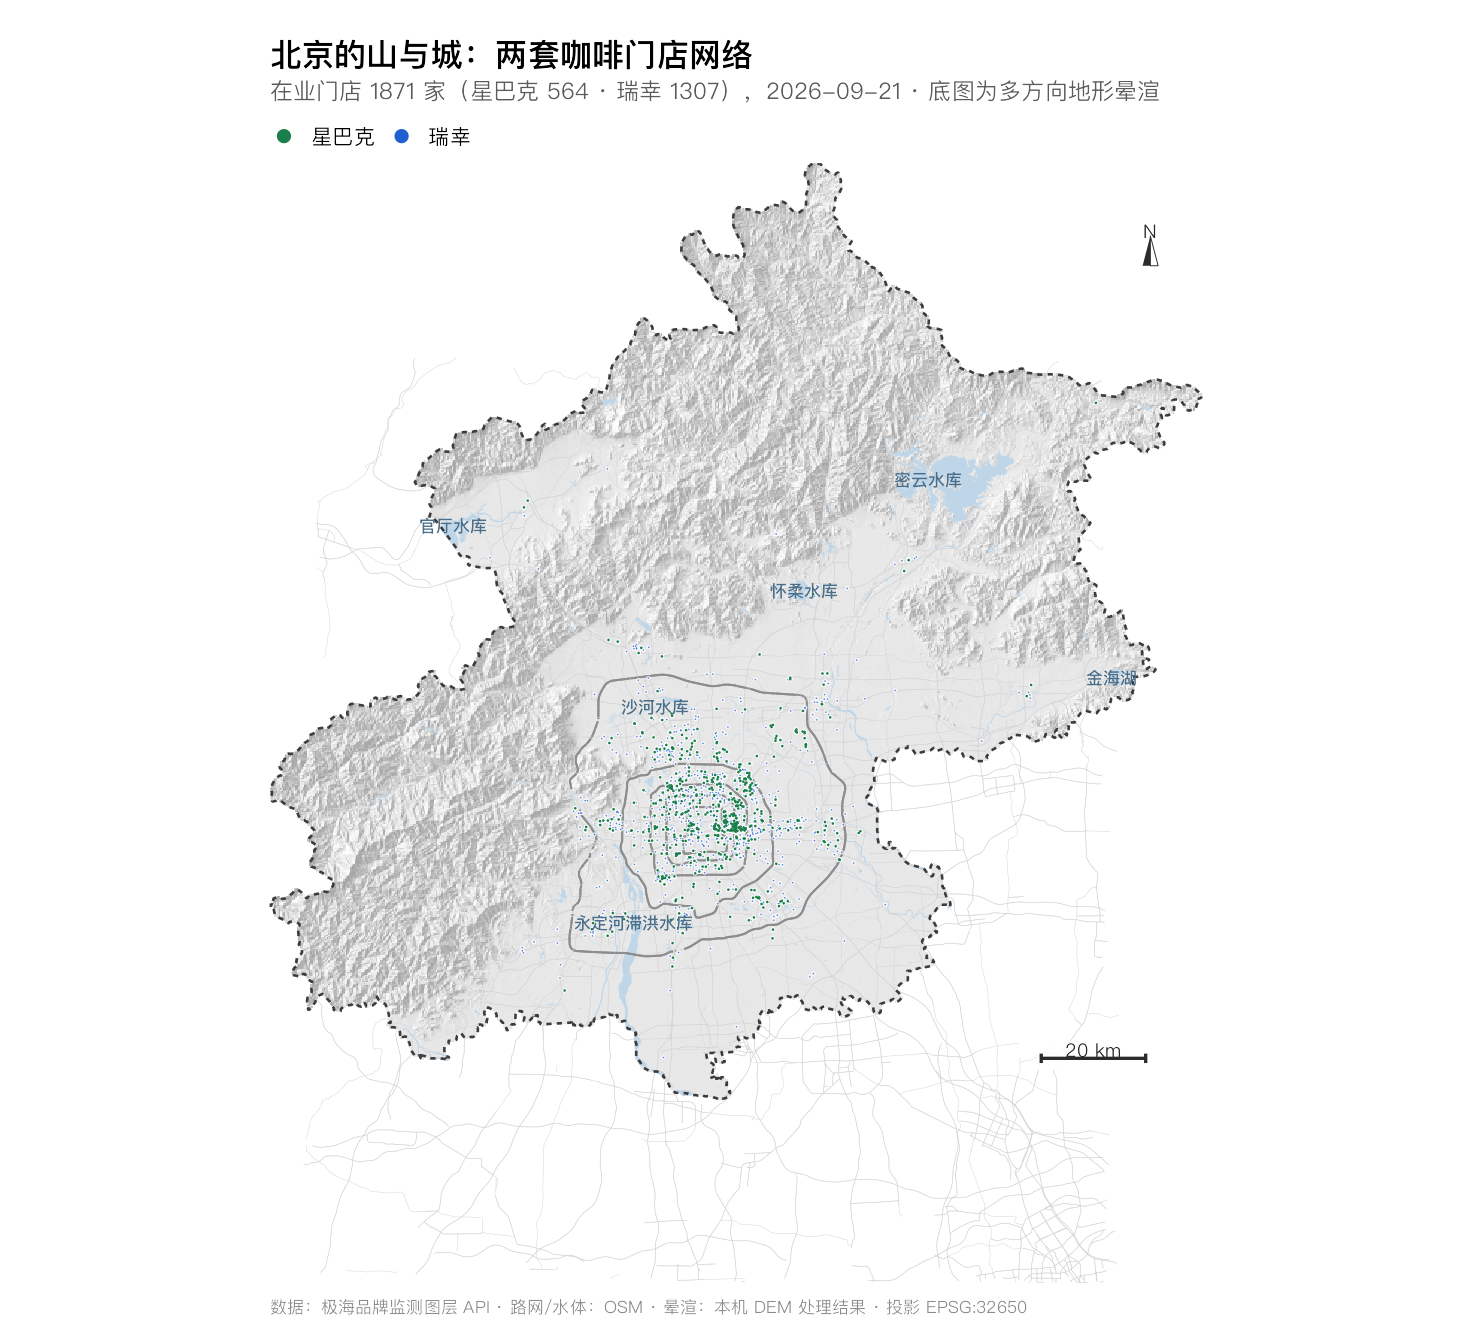
地形晕渲给出北京「西山—平原—燕山」的骨架,门店几乎全部落在平原一侧。过去这张图需要在平台里加载 DEM、配晕渲参数、叠路网图层、调符号。现在是模型一次性写出的 R 脚本——其实这是我第一次用R做地图,而且我根本也不懂R。
六边形密度图——替代:空间聚合工具、专题制图
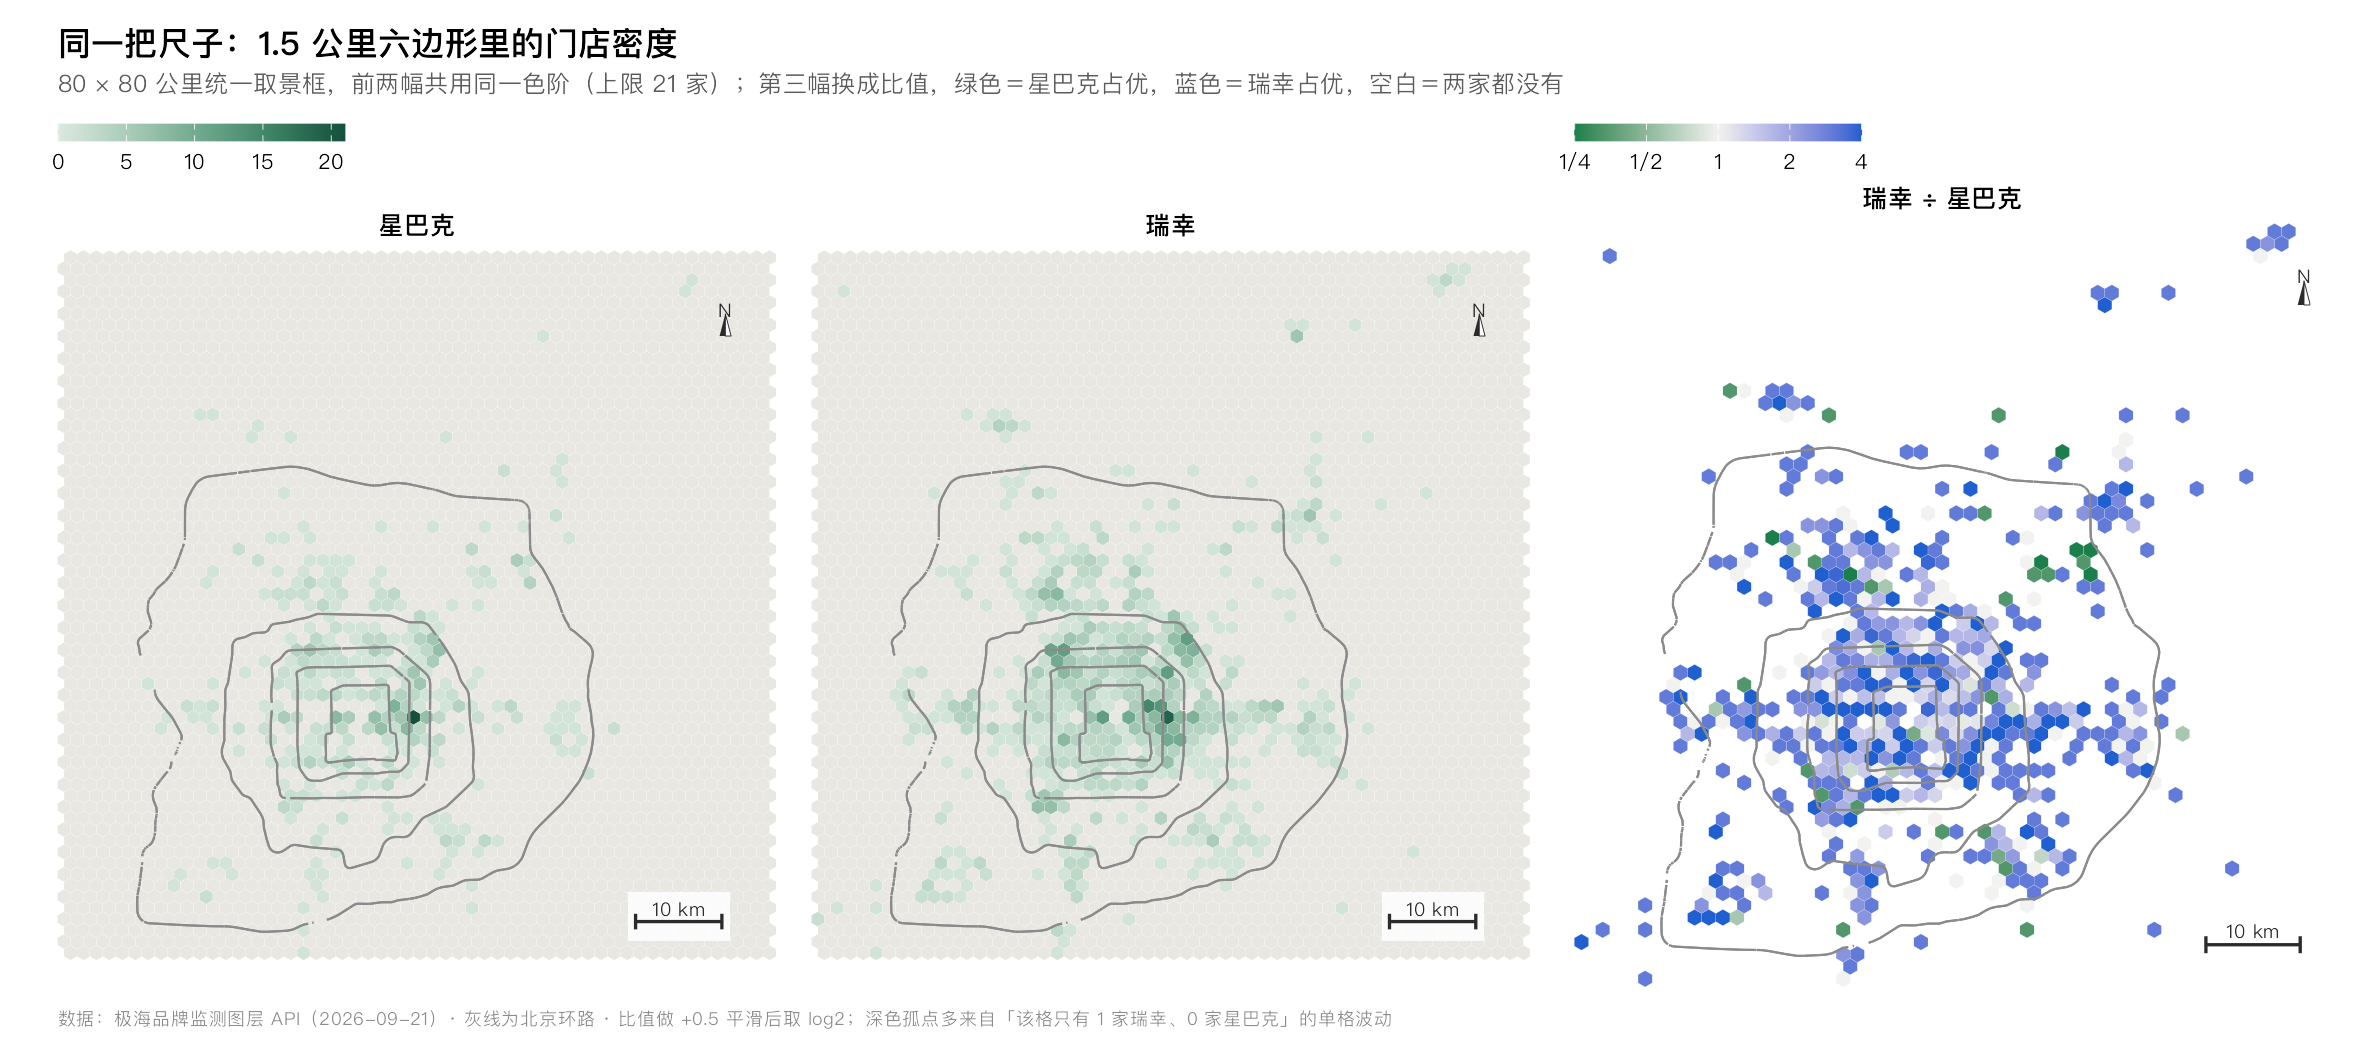
1.5 公里六边形做统一聚合,两张品牌共用同一色阶。星巴克集中在少数商圈,瑞幸铺得更均匀。过去这是 ArcGIS 里「Create Hexagonal Tessellation → Spatial Join → Graduated Colors」的标准流程。
就近优势面——替代:距离分析、栅格代数
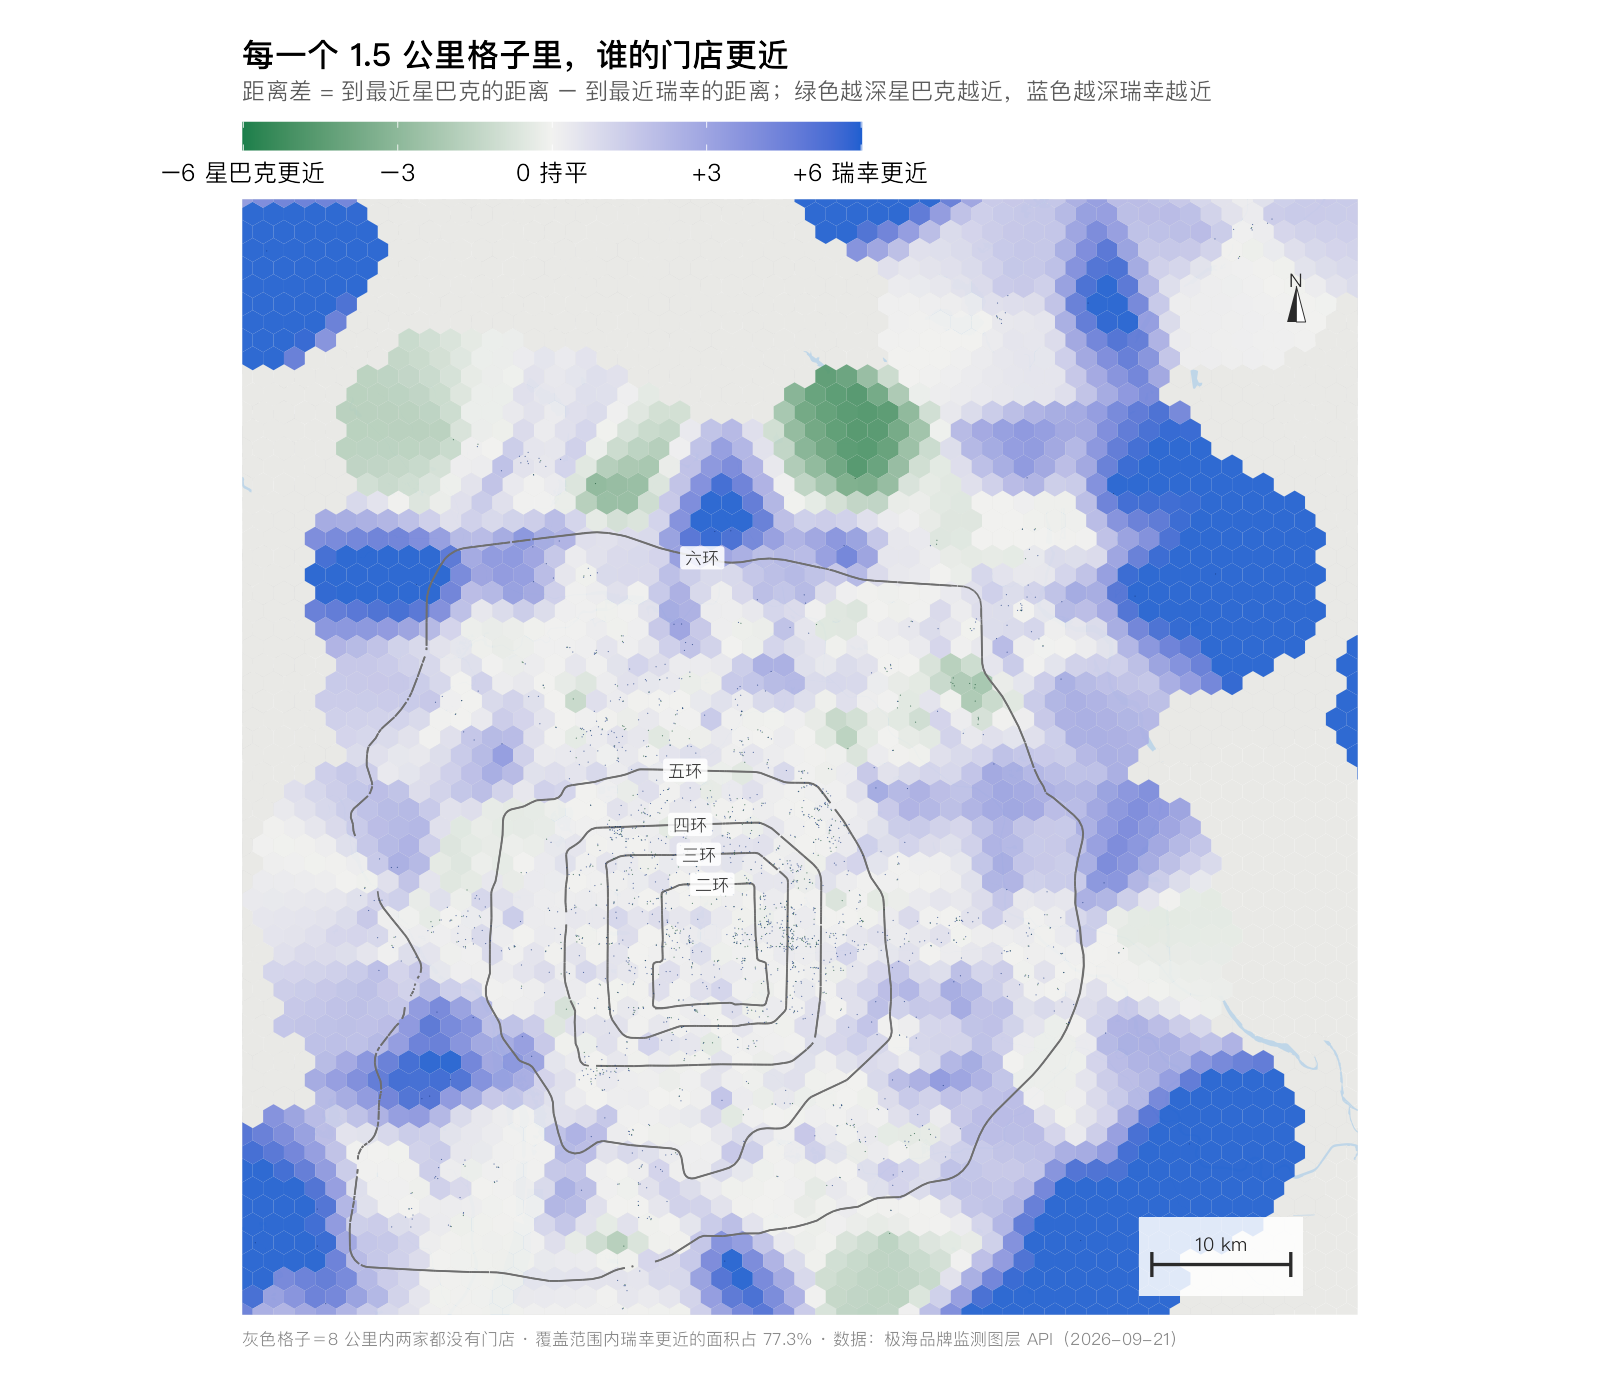
全城逐格判断谁的门店更近。在两家都覆盖到的范围内,77.3% 的面积离瑞幸更近。
最近邻距离分布——替代:近邻分析工具
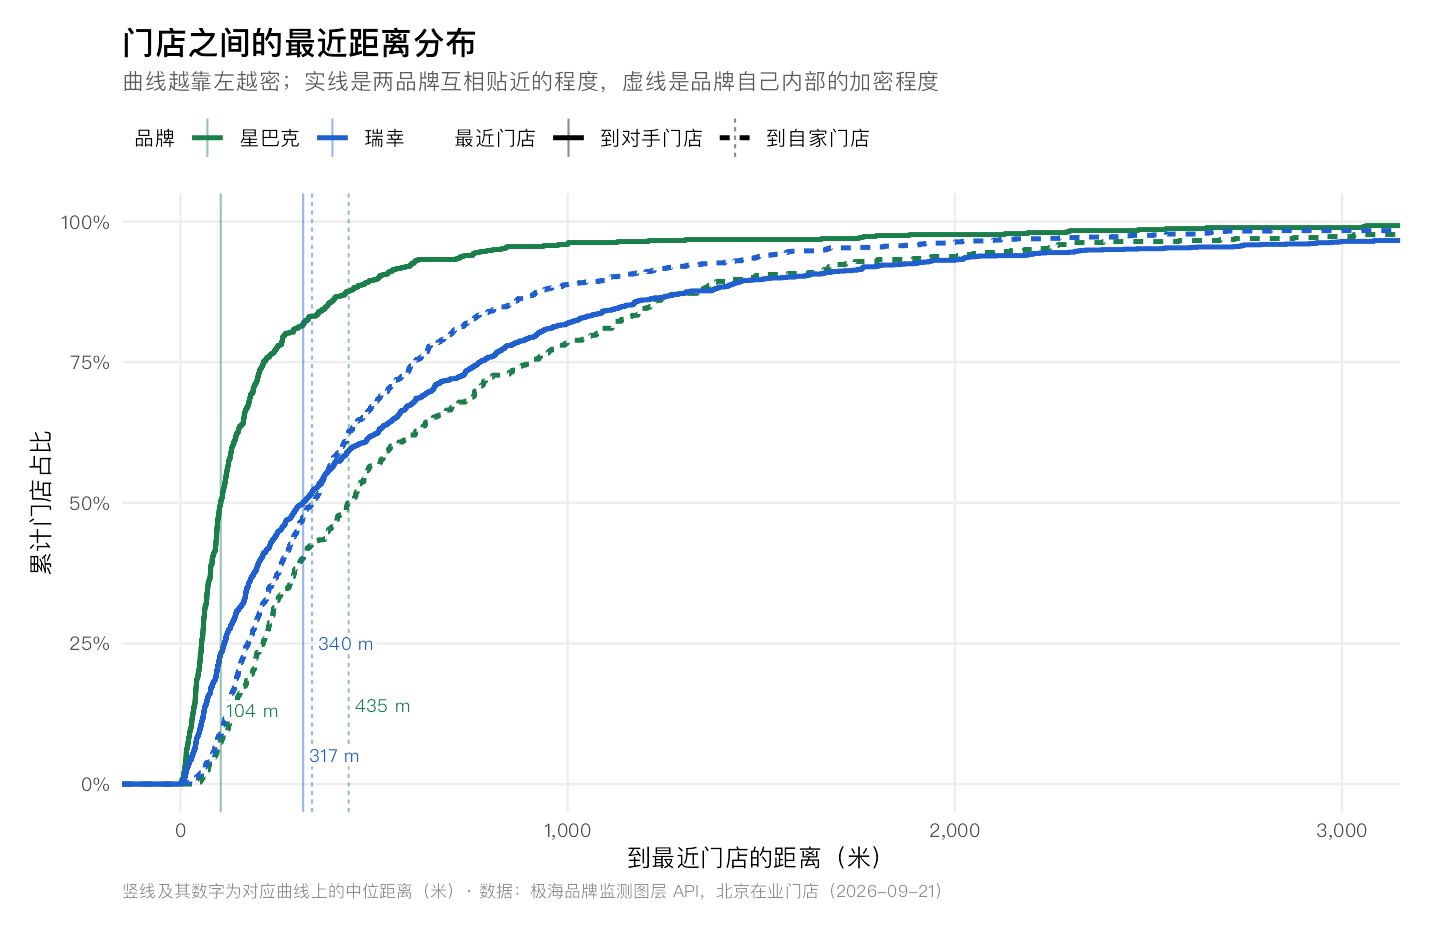
关键数字:81% 的星巴克门店 300 米内能找到瑞幸(中位距离 104 米),49% 的瑞幸门店 300 米内有星巴克(中位距离 317 米)。瑞幸自家门店的中位间距是 340 米——比它到最近星巴克还远。两家共享的是同一批高人流商业空间,把它读成「瑞幸刻意贴着星巴克开店」是过度解读。
路网可达性——替代:Network Analyst
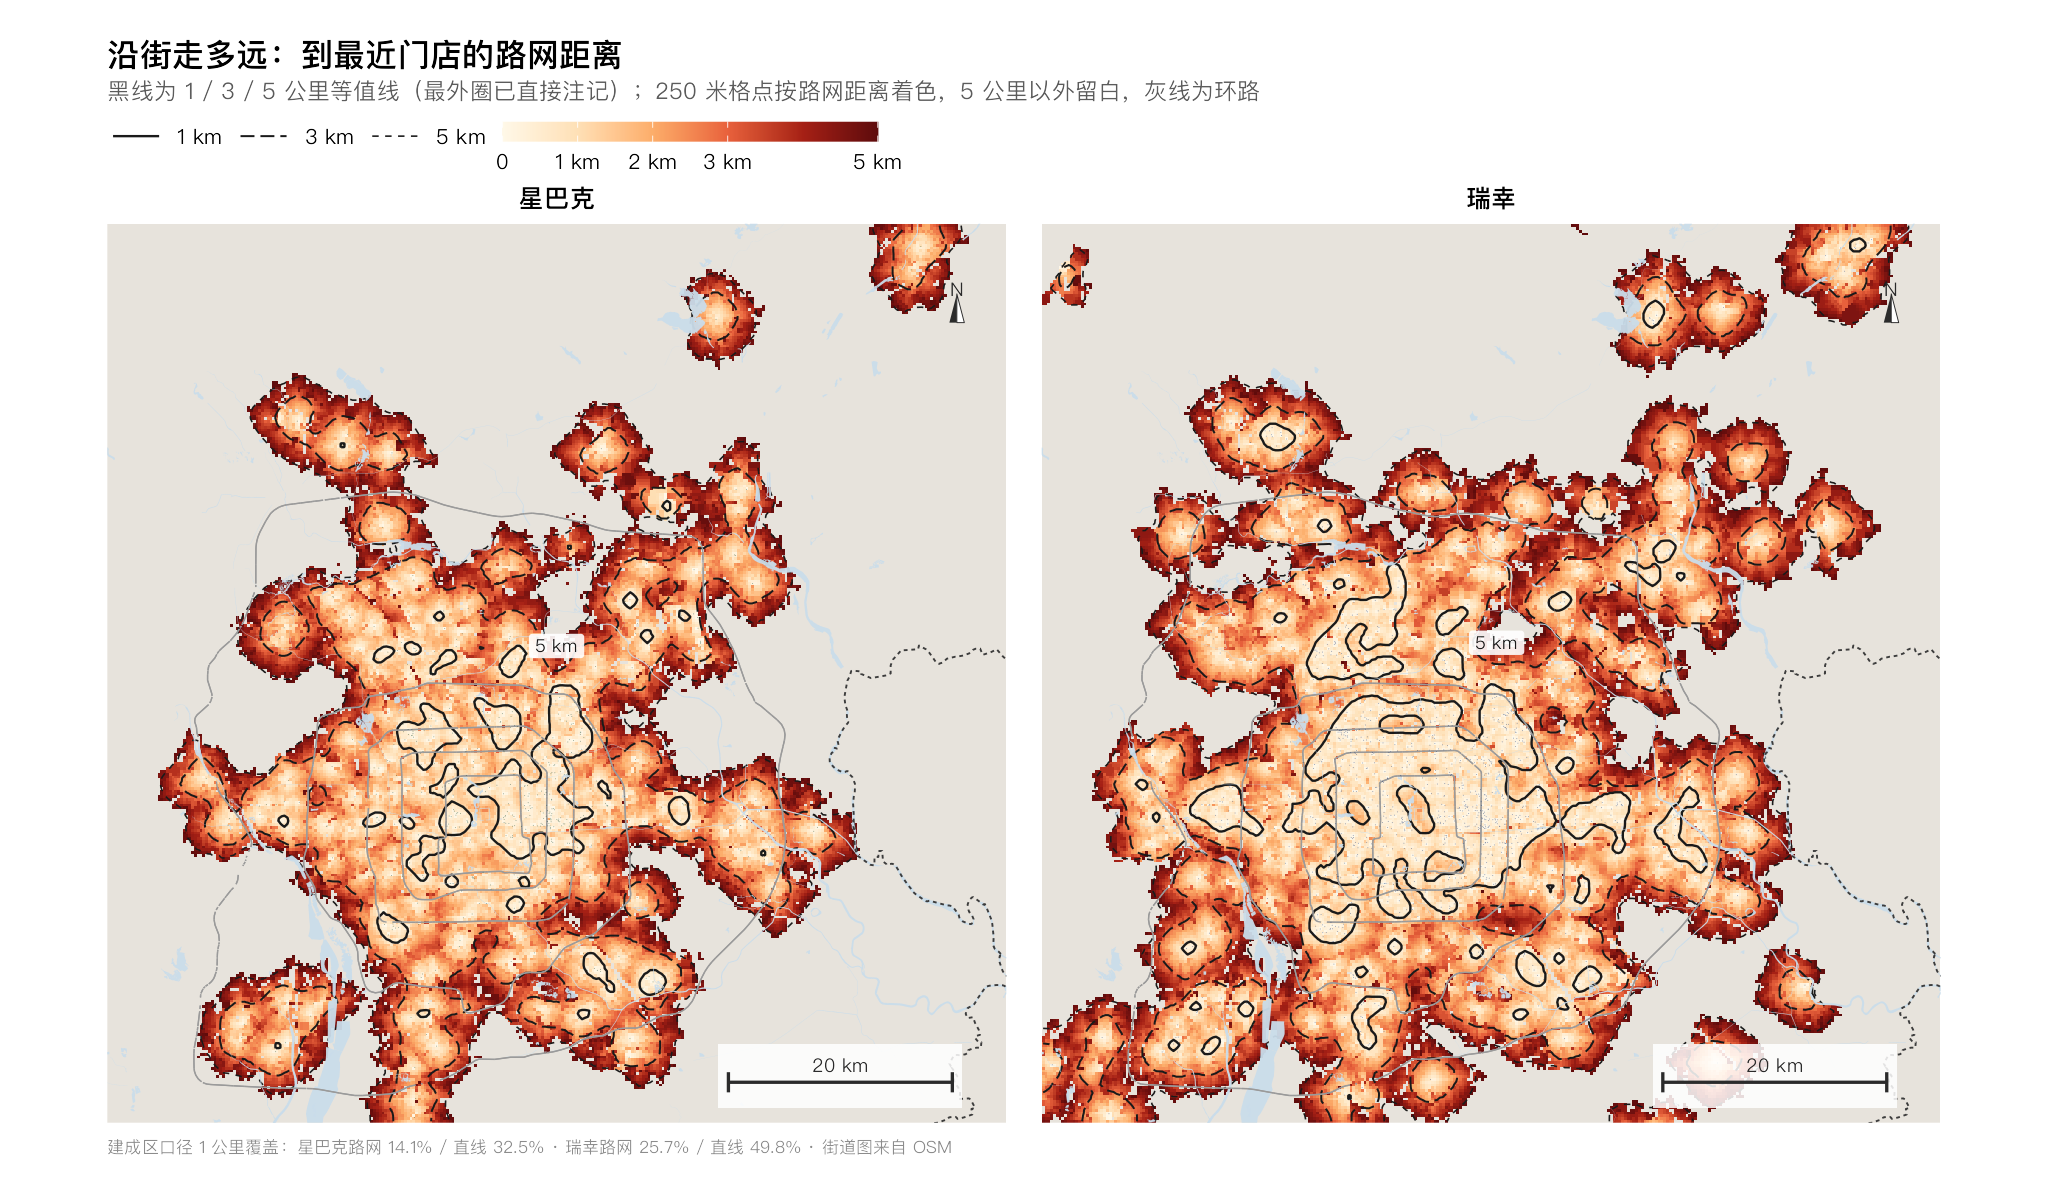
从 OSM 镜像取出北京城市道路——184 万节点、359 万条有向弧——做多源迪杰克斯拉(Dijkstra)。按街道算,瑞幸 1 公里覆盖从直线口径的 49.8% 降到 25.7%,星巴克从 32.5% 降到 14.1%。直线距离(简单画圆的缓冲区)是一张过于乐观的地图。这一步过去坐着的正是 ArcGIS Network Analyst。
绕行系数——替代:路网距离统计
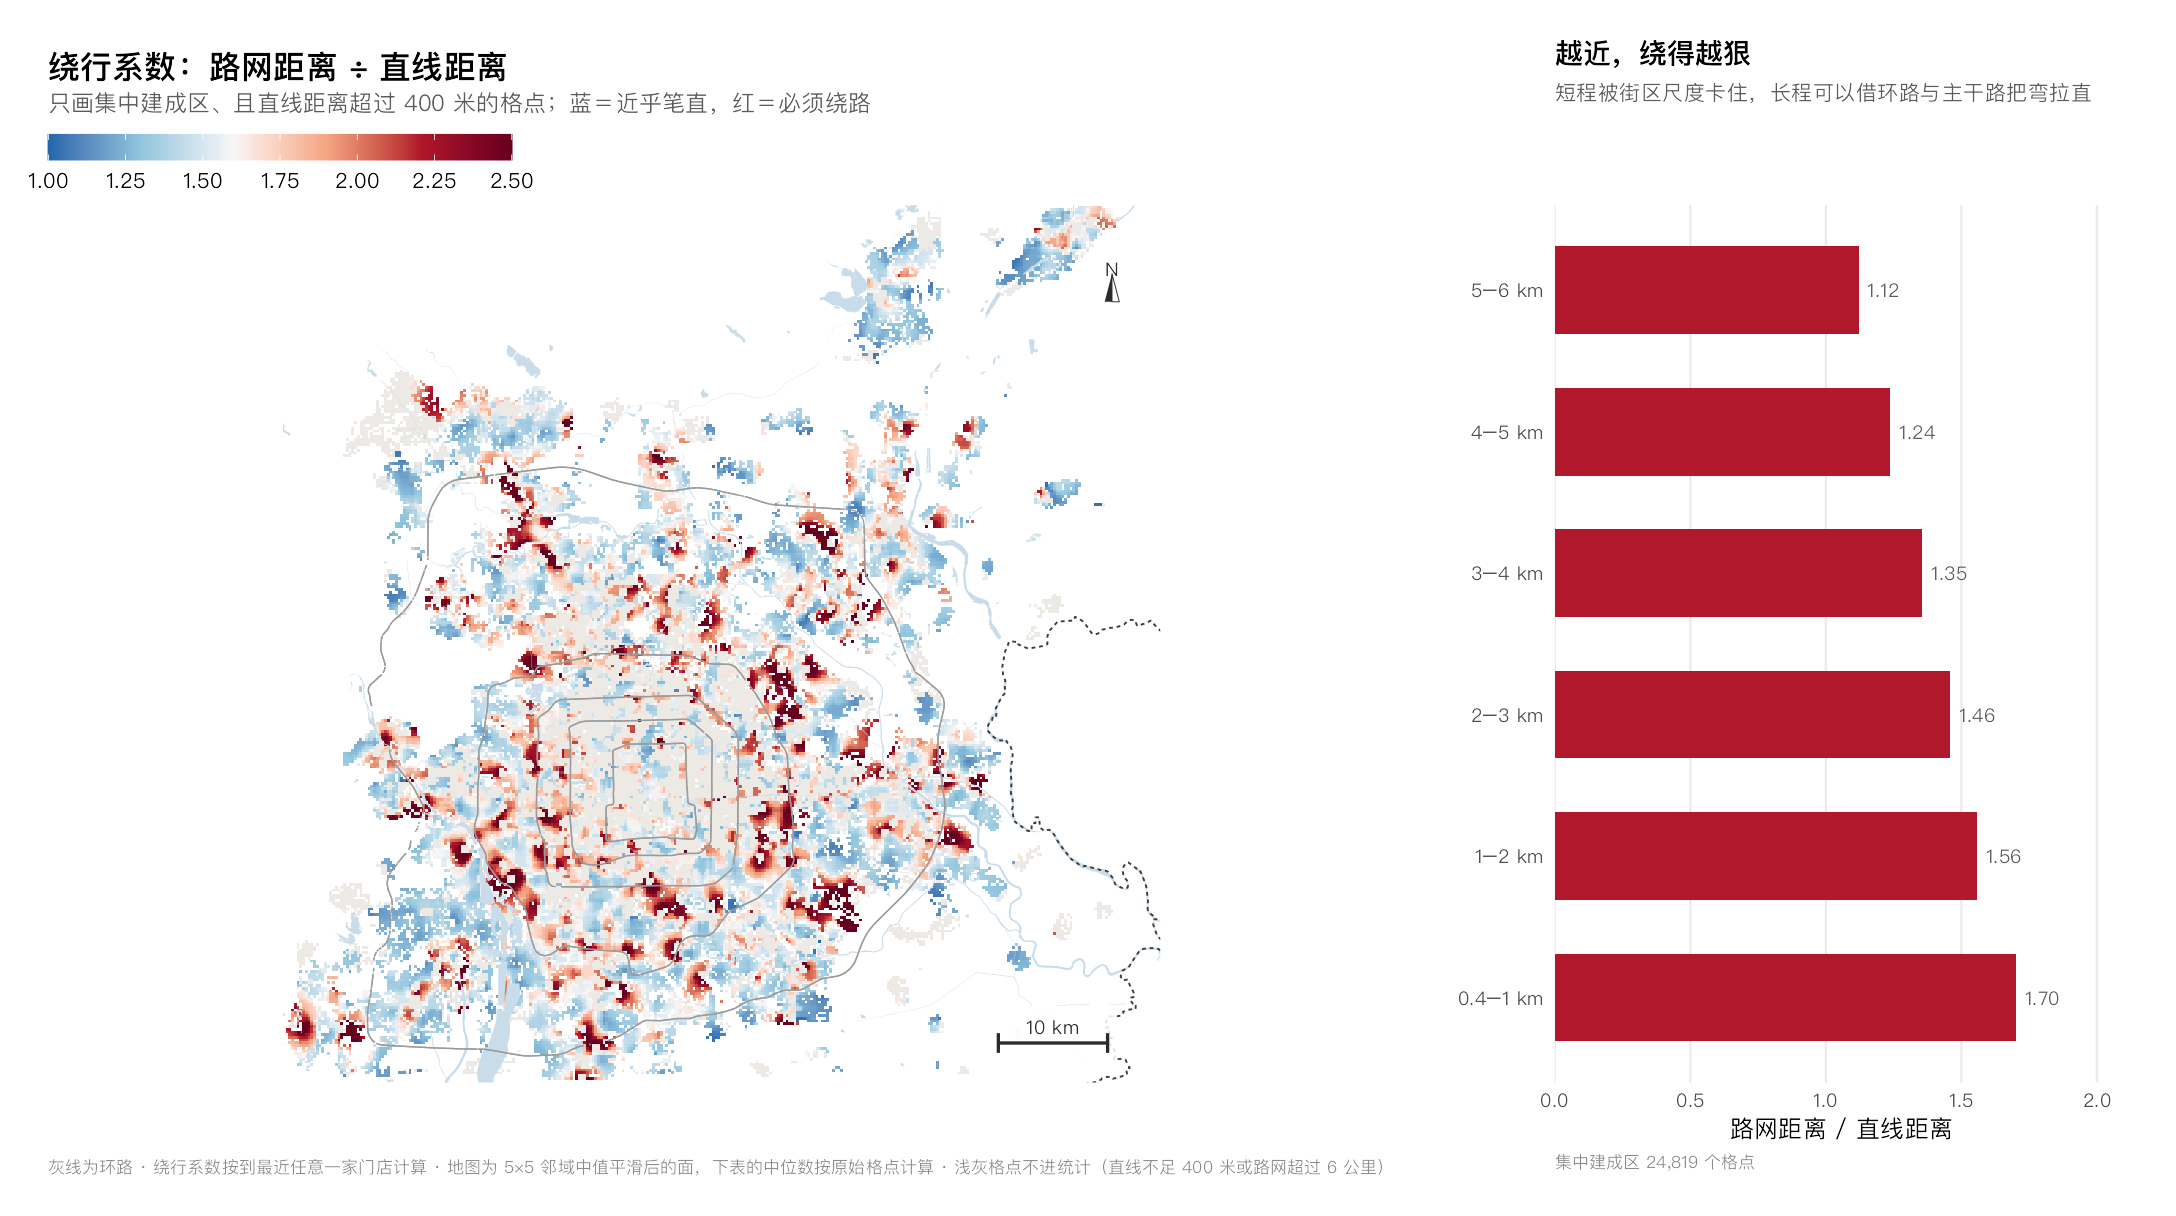
路网距离除以直线距离,中位数 1.55。越近绕得越狠:400 米到 1 公里实际走 1.70 倍,4 公里以上只走 1.12 倍。短程被街区尺度卡死。
时空扩散——替代:时间序列空间分析
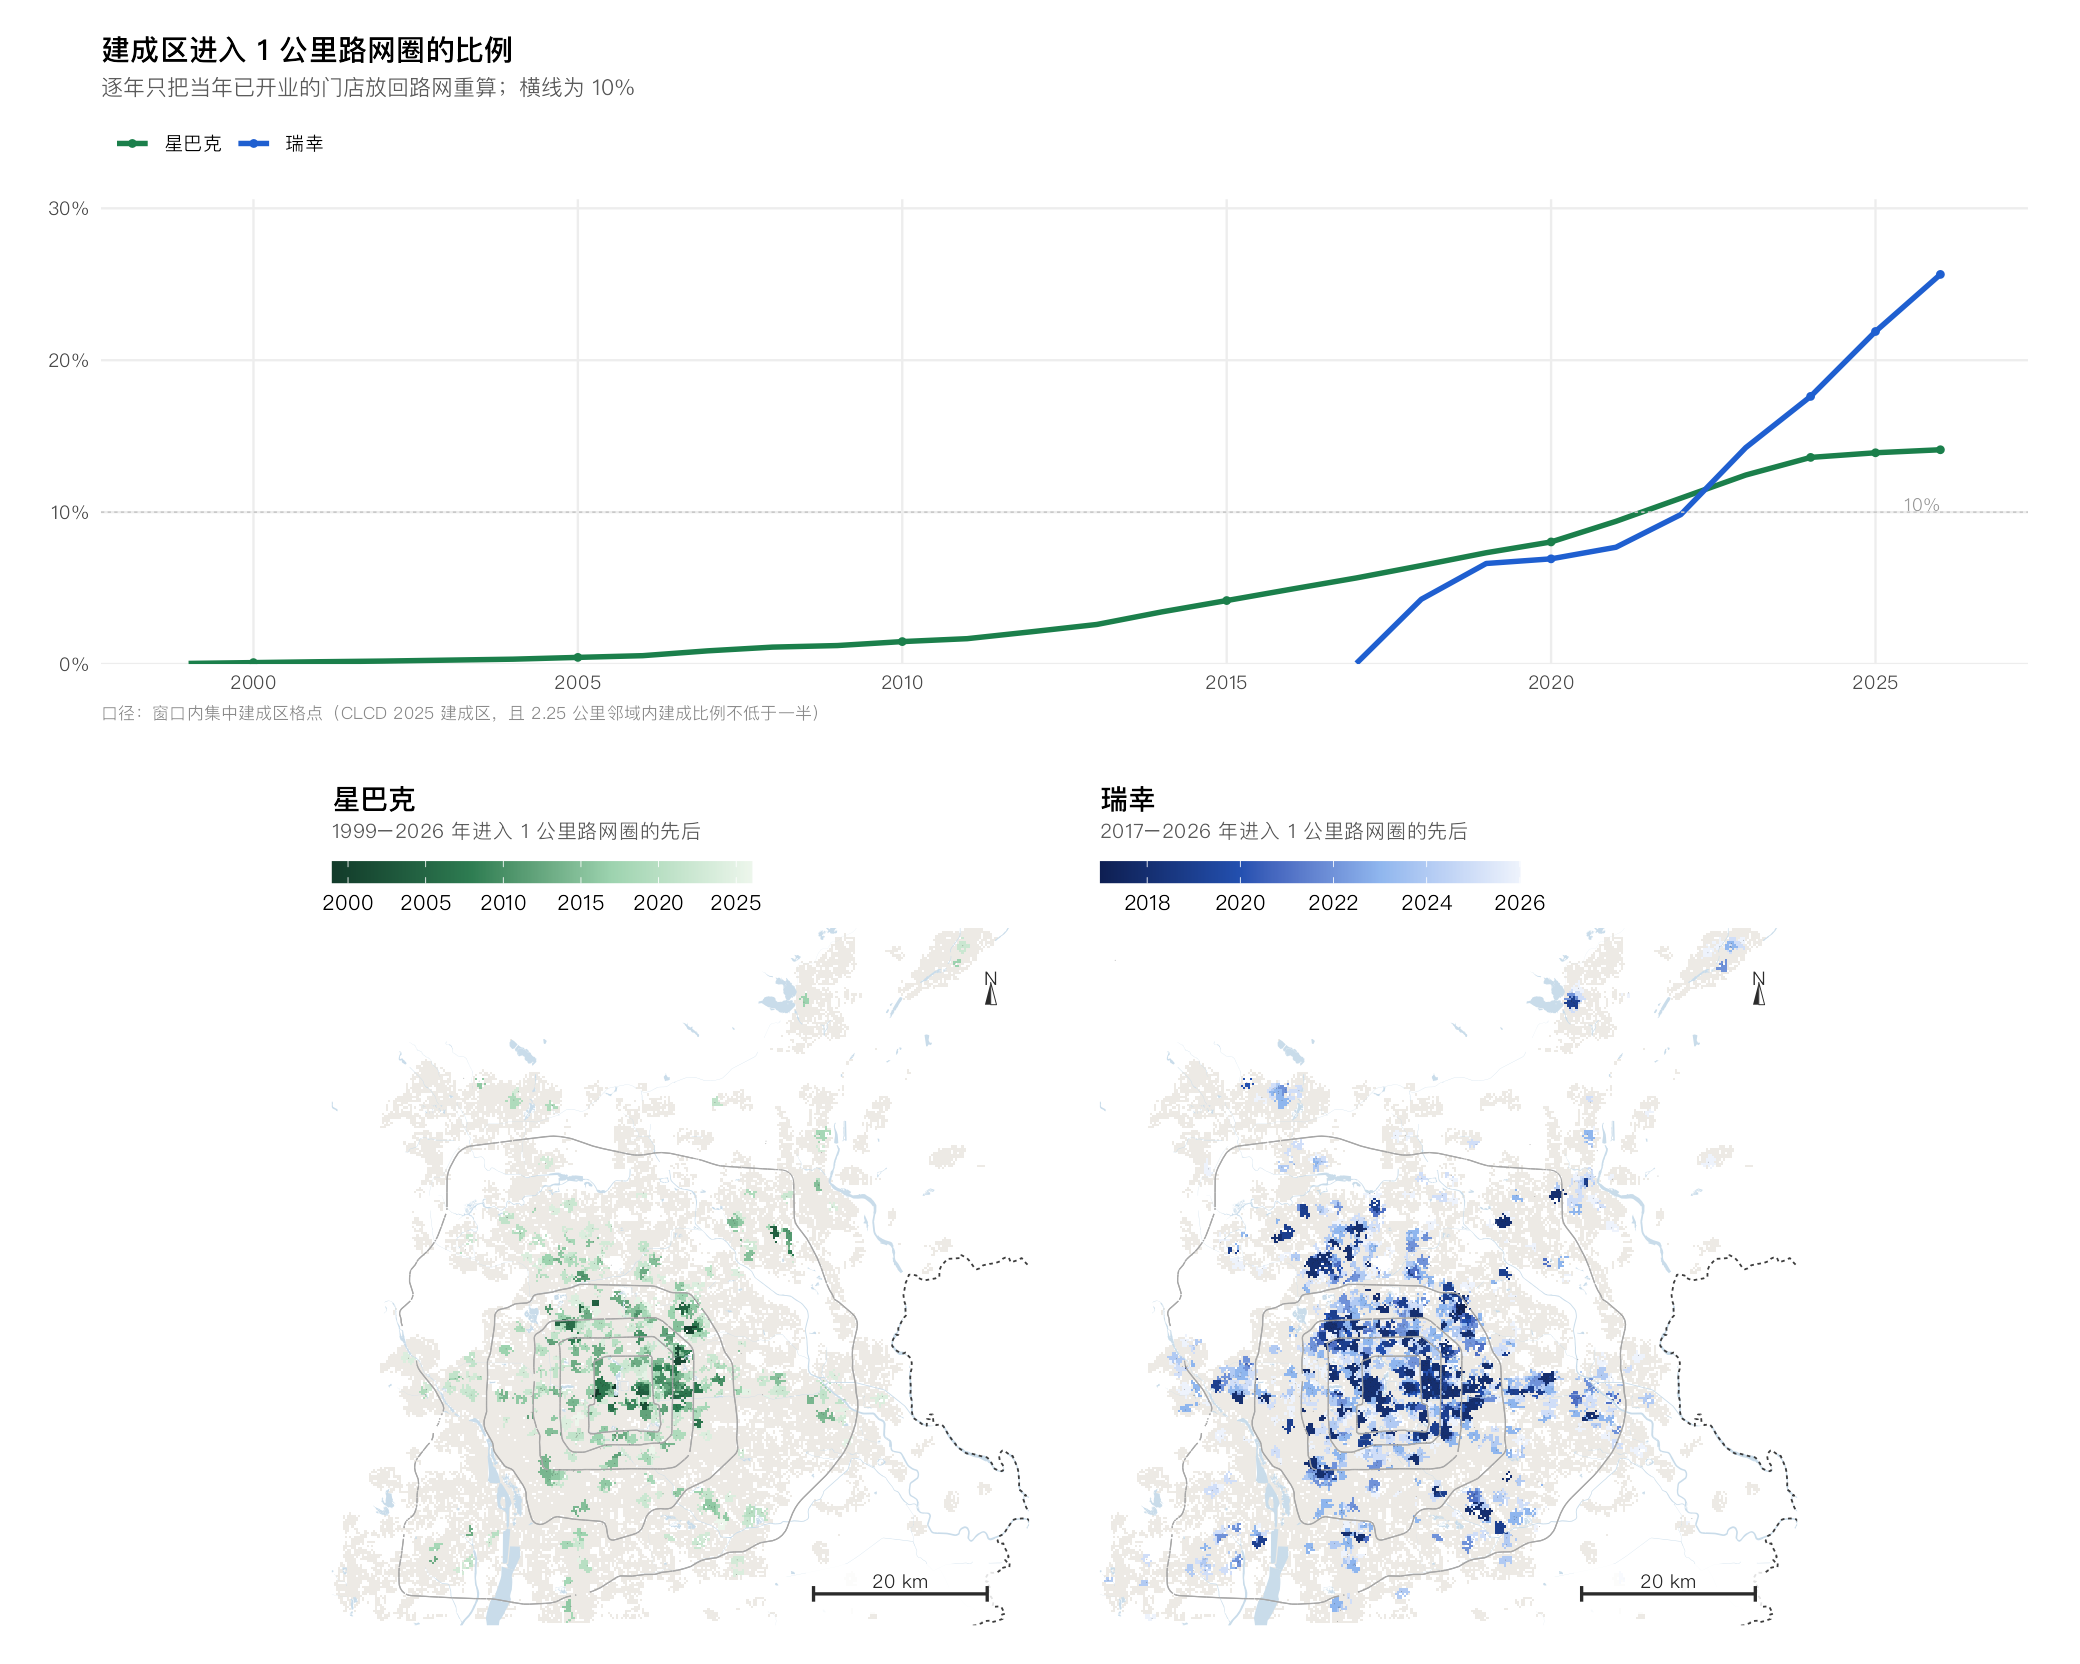
逐年只把当年已开业的门店放回路网重算覆盖。星巴克用 23 年才把 10% 的集中建成区纳入 1 公里路网圈(2022 年),瑞幸 6 年就做到了(2023 年)。
商圈主导权——替代:空间连接 + 专题制图
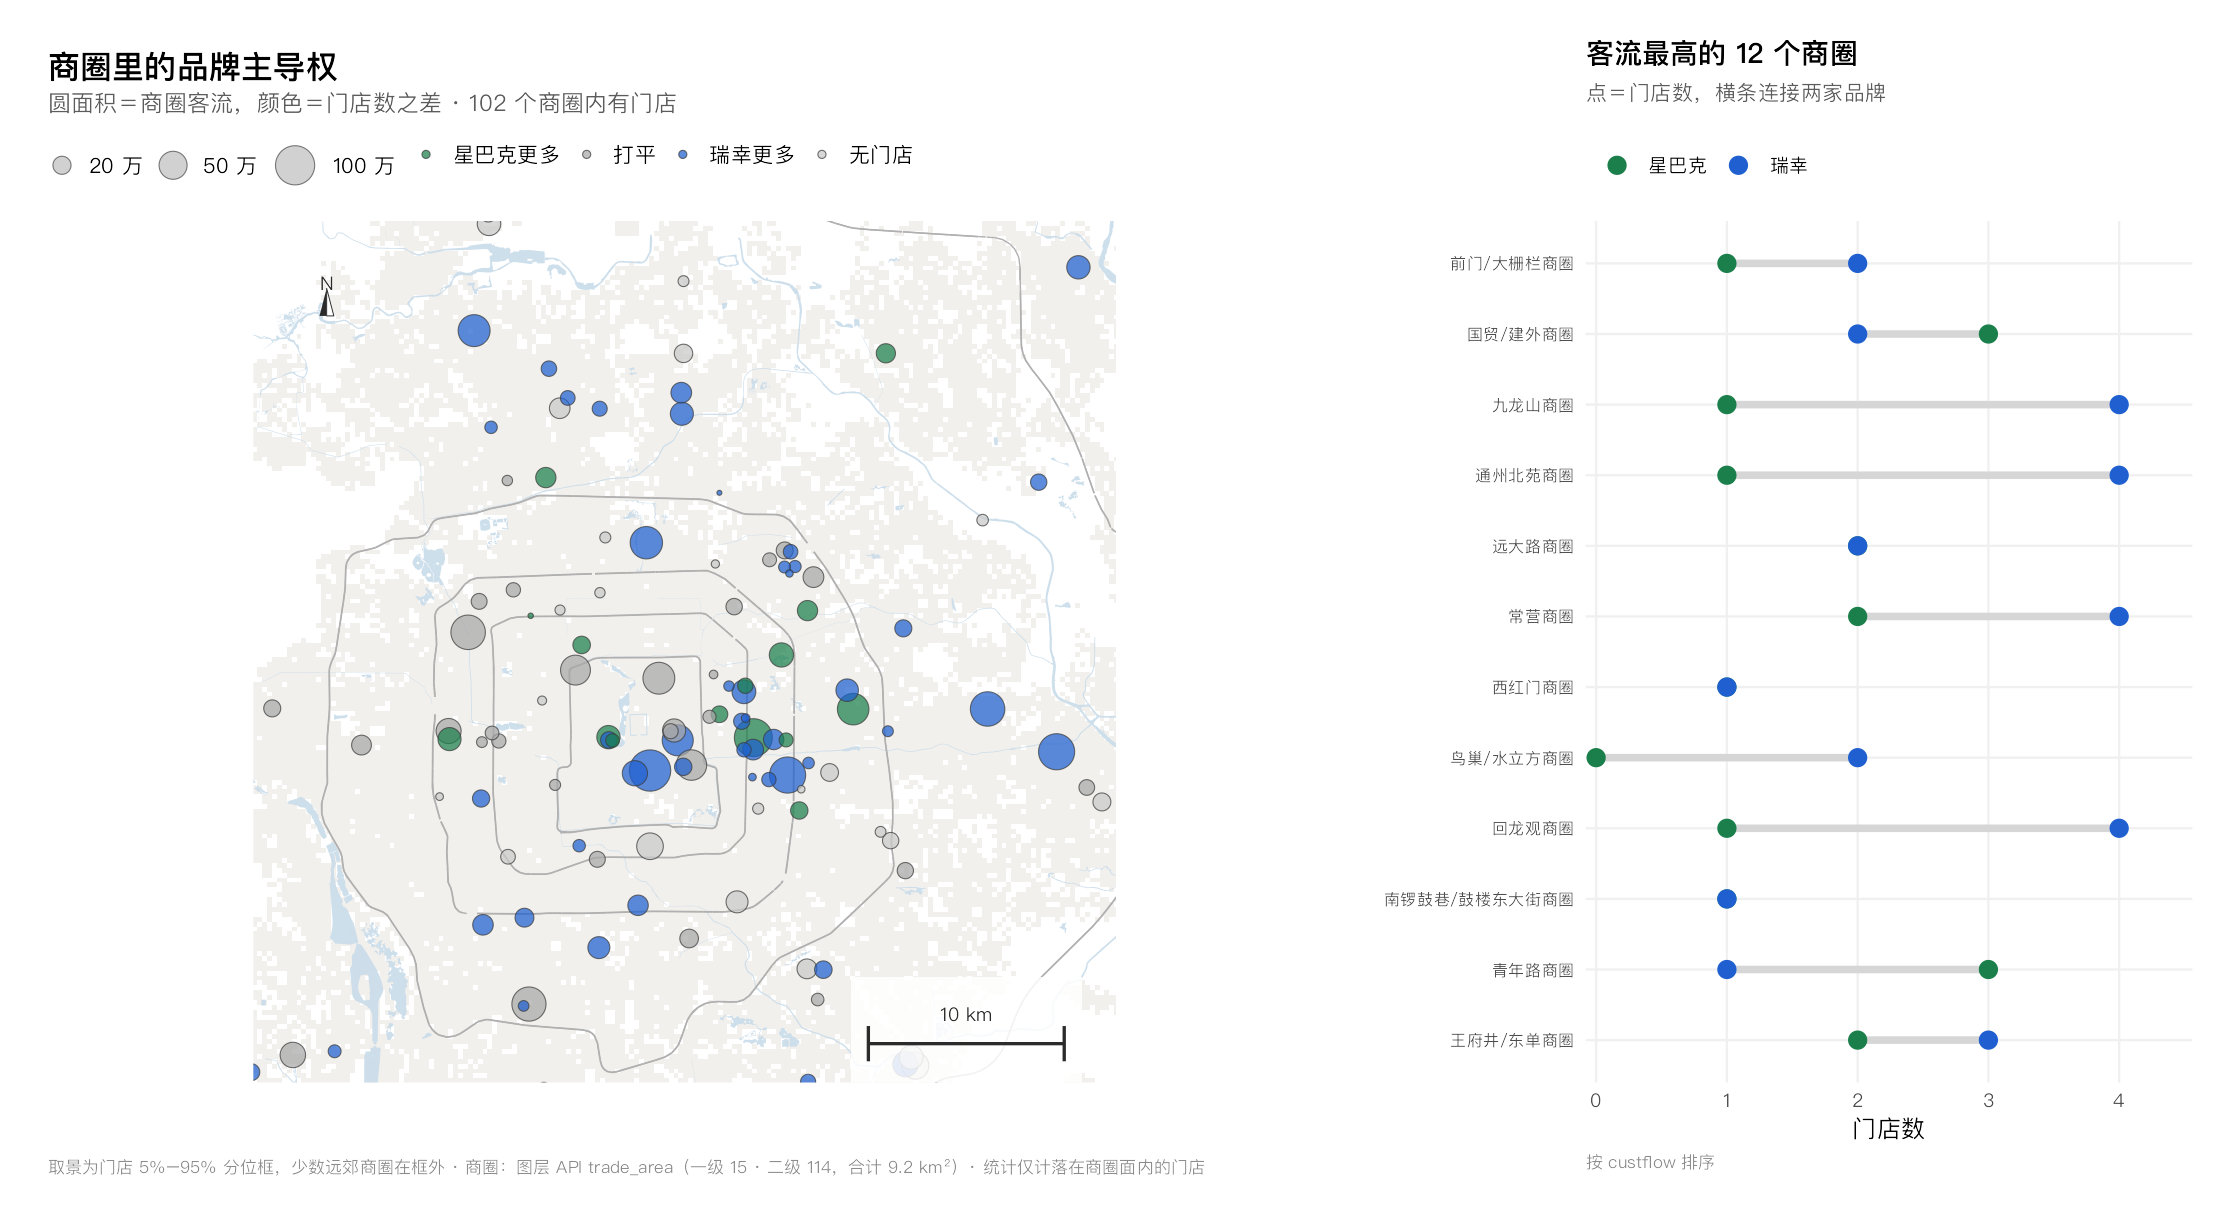
129 个商圈里,瑞幸门店更多的 53 个,星巴克 15 个,打平 34 个。
八张图,四张建立在真实路网上,整条链路——取数、建图、最短路、等值线、时间序列、空间连接——没有一个环节需要打开 GIS 平台。
五、验证:平台剩的三件事靠谱吗
第三节说平台只剩数据运维、API 契约、鉴权三件事值得花钱。这个判断需要验证。
数据运维:已经能被 agent 接管。 快照文件名带日期,路网清单写进 manifest,整条流程从本地快照重跑——关掉图层 API,八张图照样出得来;同一份快照跑两次,37 个 cell 的输出逐字节一致。验收标准比平台时代更严:不是「数据库连得上」,而是「数据源关掉还能重建」。
API 契约:责任在平台方,可以被客观打分。 同一个任务,给模型 (a) 只有端点列表 vs. (b) 加上消费指南,比一次跑通率和试错轮数——形容词就变成了数字。
鉴权:没有被接管,只是下移了。 凭证从平台服务端搬到了环境变量和配置文件里,但签发 token、配额度、限流、计费仍然需要一个治理方。这是三者里唯一还需要"平台"(或某个等效角色)的理由。
结论:平台从「工作的地方」退成了「授权的地方和供数的地方」。在平台里操作图层、点菜单、排版出图的理由消失了;剩下的是一根管道和一张票据。
六、回到那个测绘单位
现在我可以很有信心的回答那位领导的问题了。
他说各部门各自为政,需要一个平台来打通。拆开看:
烟囱问题是管理问题,不是平台问题。 制图部门不愿意把数据给遥感部门,不是因为格式不通,而是因为没有动力、没有流程、没有考核。上一个 ArcGIS 并不会改变这些。过去二十年无数单位验证过这一点。
"统一平台"的真正代价是锁定。 选了超图就要学 iObjects,选了 ArcGIS 就要买 License,所有二次开发绑定在一个厂商的 SDK 上。一旦迁移,沉没成本巨大。这在平台是唯一选择的年代还能忍,在大模型时代就是纯粹的负资产。
应该花钱的地方是数据治理和 API 契约。 让每个部门把自己的数据资产清点清楚,以稳定的、文档健全的 API 暴露出来——返回结构确定、参数语义明确、已知的坑写成文档。做到这一步,无论是人还是 agent,无论用 Python 还是 R 还是任何未来的工具,都能消费这些数据。这比让所有人学同一个平台有效得多。
权限体系要建,但不必依附于 GIS 平台。 签发 token、分配配额、审计访问日志——这些可以用任何身份管理系统来做,不需要捆绑在 GIS 软件的 Portal 里。
一句话:不买平台,要买,也得要求平台方能打通管道。
七、模型越流畅,判断力越稀缺
最后要说一个不那么乐观的事。
上面八张图里,至少有三处「模型算得流畅、但结论是错的」:
- • 首版 Python notebook 的比例是 93% 和 63%,其中 63% 和 317 米中位距离自相矛盾——改用 R 重算后修正为 81% 和 49%;
- • 分母口径的选择(全市域 vs. 集中建成区)差出一倍;
- • 绕行系数的方向(短程反而比长程绕得狠)和直觉相反,需要停下来想为什么。
每一处都不是工具问题,是判断问题。而模型越流畅,验收越容易被跳过。首版的 93% 写得比修正后的 81% 更有说服力——数字更大、语气更笃定、图也更好看。
产出成本趋近于零之后,验收变成了唯一的成本项,而人天然倾向于跳过成本。平台时代出图慢、流程重,反而逼着你在每一步停下来看;现在一句话出八张图,停下来看的动机消失了。
对那个测绘单位来说,这意味着:与其花钱培训所有人学一个平台,不如花钱培养能验收结果的人。 能把「这个数怎么来的、边界在哪、什么时候不成立」说清楚的人,比会操作任何软件的人都值钱。
结语
GIS 平台之死,死的不是地理信息产业,而是「把知识和工具封进重型软件、再通过许可证和培训体系分发」这种形态。知识进了模型,工具随用随造,界面让位于对话。
平台退回它唯一还说得出口的两句话:我把数据供好,我给 agent 发通行证。
对那个测绘单位的领导来说:你不缺平台,你缺的是让数据流动的管道和验收结果的人。
对 GISer 来说,这不坏。枷锁和护城河常常是同一样东西——平台困住你的那部分消失了,剩下的全是长本事的部分。