连上空间数据库之后,智能助手还差什么
这段时间和不少同行朋友交流,发现大家面对的是同一道题:领导在会上问“我们怎么用 AI 提效”,回去以后,几乎所有人都想到同一个答案——做一个懂公司内部知识的智能助手。虽然这是最朴素的答案,但这 AI 的发展一日千里,怎么感觉做个对话式的助手,都是上辈子的事情了。
在我们这个小小的细分行当,常见做法分两步。先把制度文件、选址报告、商圈分析做成知识库,模型回答前先检索相关段落,也就是常说的检索增强生成(RAG);再把空间数据库接给模型,让它把口语翻译成空间查询语句。
但这样做完之后,很多人会有一种两头不着落的感觉:只会查库,显得太简单,撑不起领导的期待;真要回答业务问题,又总差一口气。
我们自己在这件事上也琢磨了很久。我现在的判断是,“这口气”不在模型,也不在“连没连上内部数据”,而在于数据有没有被改写成 AI 能正确使用的样子。
极海做地理数据十几年。极海品牌监测跟踪全国七十多个行业、全球两万多个连锁品牌,门店数据从品牌官网和小程序每日采集,并区分在营与已闭店。过去这些数据是给人用的:网页、报表、分析师。最近一年我们一直在想,如果读数据的不是人,而是 AI,数据要怎么改。
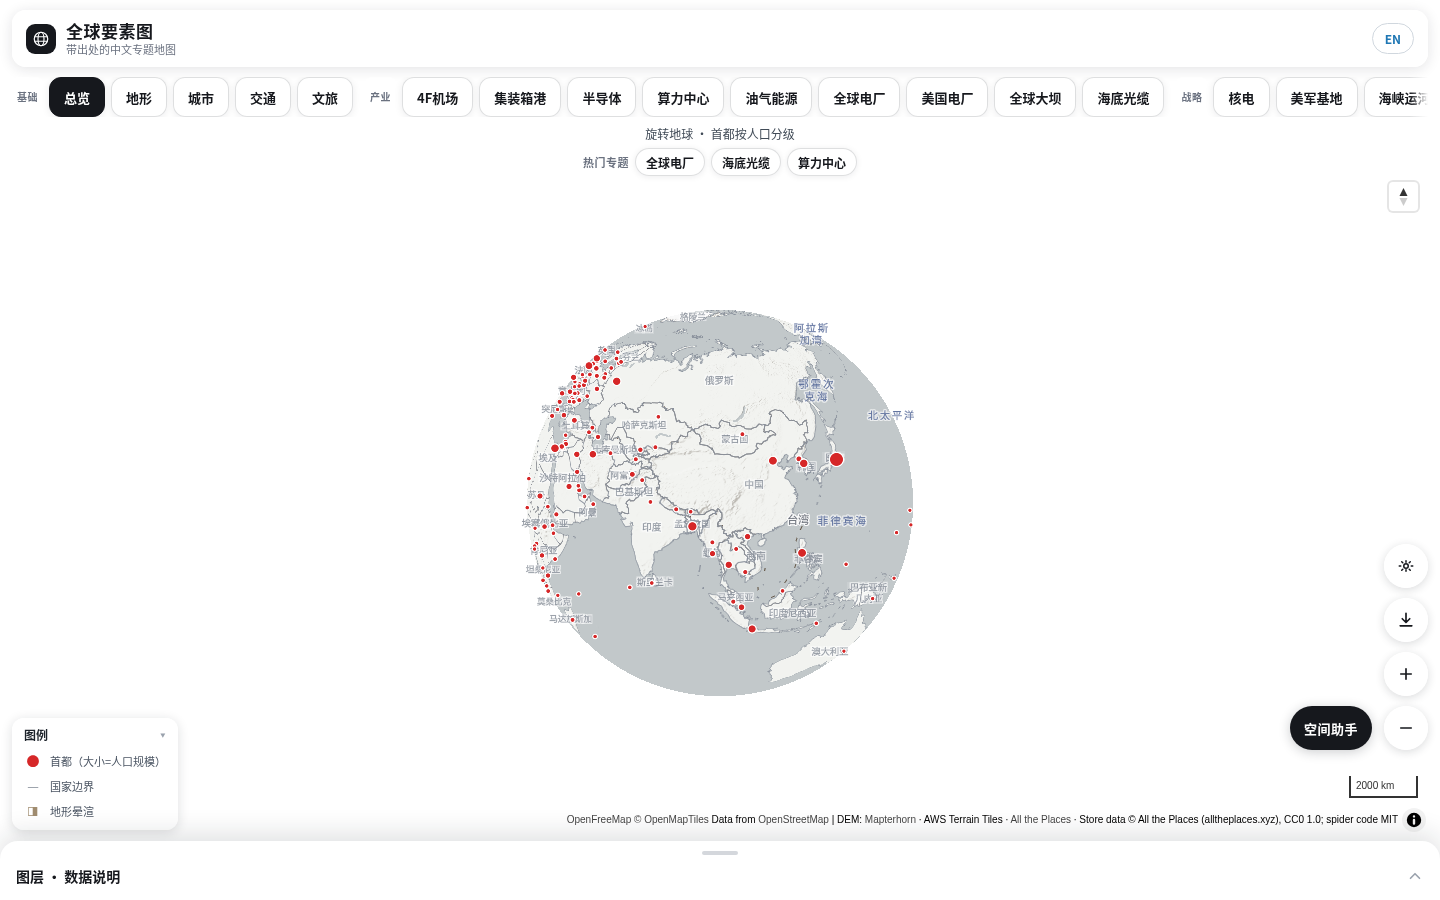
为了把这个问题想清楚,我借着上两周的demo,继续做这个公开实验:全球要素图(map.kowa88.net)。它把晶圆厂、核电、港口、海底光缆等三十多个专题叠在一张世界地图上;这周把连锁门店部分,接入极海品牌监测的API。在地图右下角增加一个“空间助手”,下面的探索例子都来自它。
一句“沈阳在营肯德基”,背后有几道题
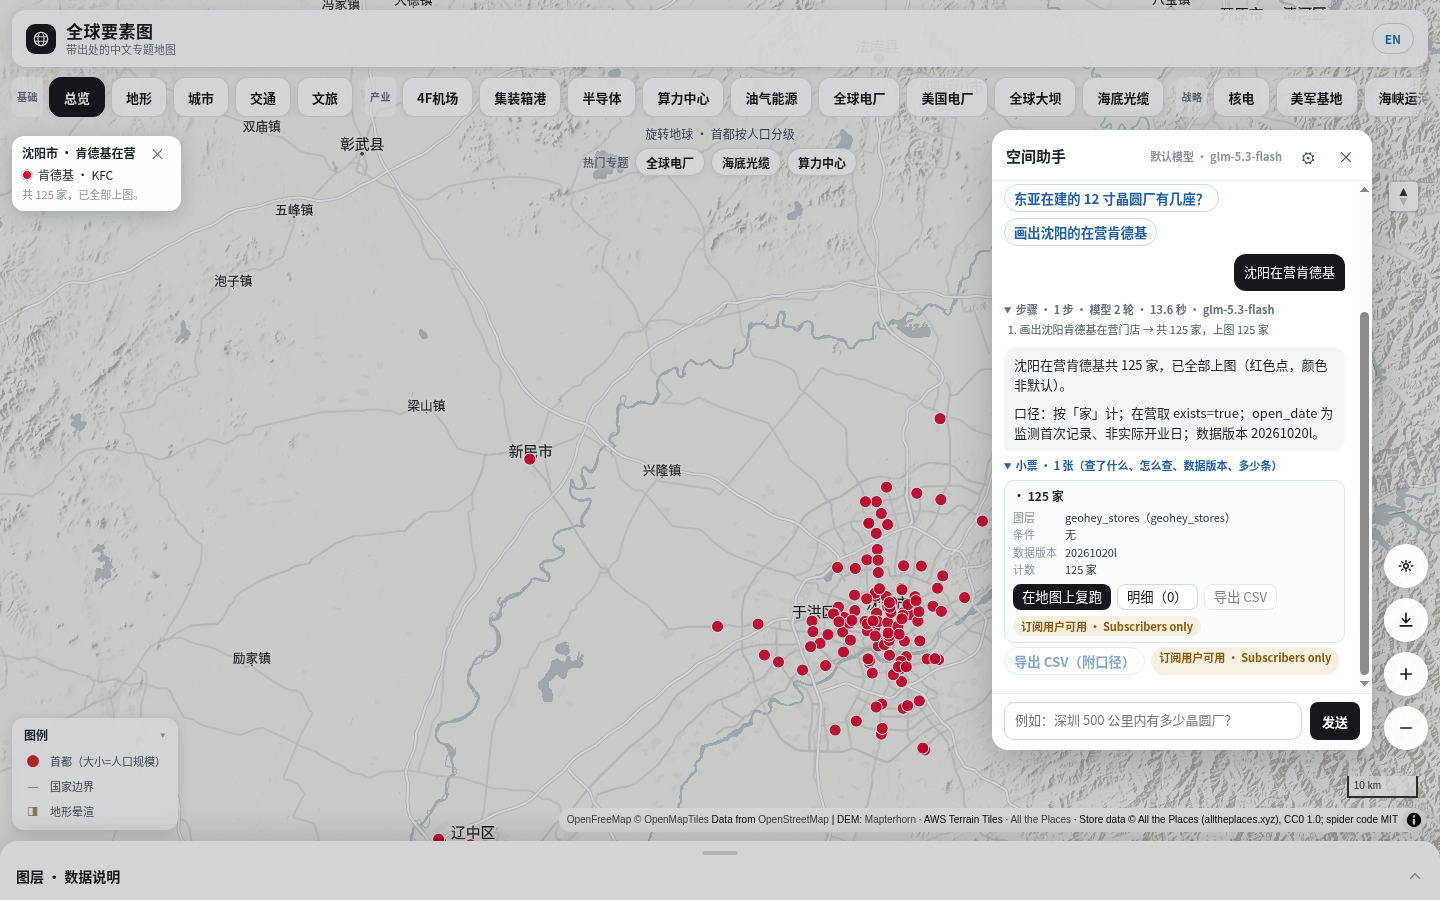
在助手里输入“沈阳在营肯德基”,大约 14 秒后,地图上出现 125 个红点,回答是:沈阳在营肯德基共 125 家,已全部上图。
这句话看起来简单,背后至少有几道题。
“沈阳”指沈阳市的行政范围,不是以市中心画一个圈。“肯德基”要对应到品牌实体,不能把名字里带这三个字的别的店也算进来。最难的是“在营”。一家店算不算在营,取决于数据怎么采:极海以小程序能否下单作为主要依据,再参考官网等渠道。所以回答里有一句容易被忽略的话:开店日期字段是首次监测到的记录,不代表实际开业日。
如果只是把数据库连给模型,这些信息都不在列名里。模型看到一个日期字段,会很自然地把它当成开业日,然后告诉领导“沈阳去年新开了多少家”。查询语句完全正确,结论却是错的。
计数也一样。125 由程序算出,不是模型从列表里数出来的。每个回答下面都有一张“小票”,写明查了哪一层、哪个数据版本、多少条;回答里的数字如果在小票上找不到,就会被标成灰色。
给人用的数据,和给 AI 用的数据
给人用的数据,通常是分页列表、筛选器和图表。口径不清楚,人会去翻说明;一页看不完,人会翻页。给 AI 用的数据,要反过来设计。
问“全国在营肯德基”,助手一次请求拉回完整的一层,共 14,298 家。我们内部测下来,拉回大约 14 秒,画到地图上再用 10 秒左右;写这篇文章时连跑两次,界面显示的总耗时分别是 16 秒和 30 秒。
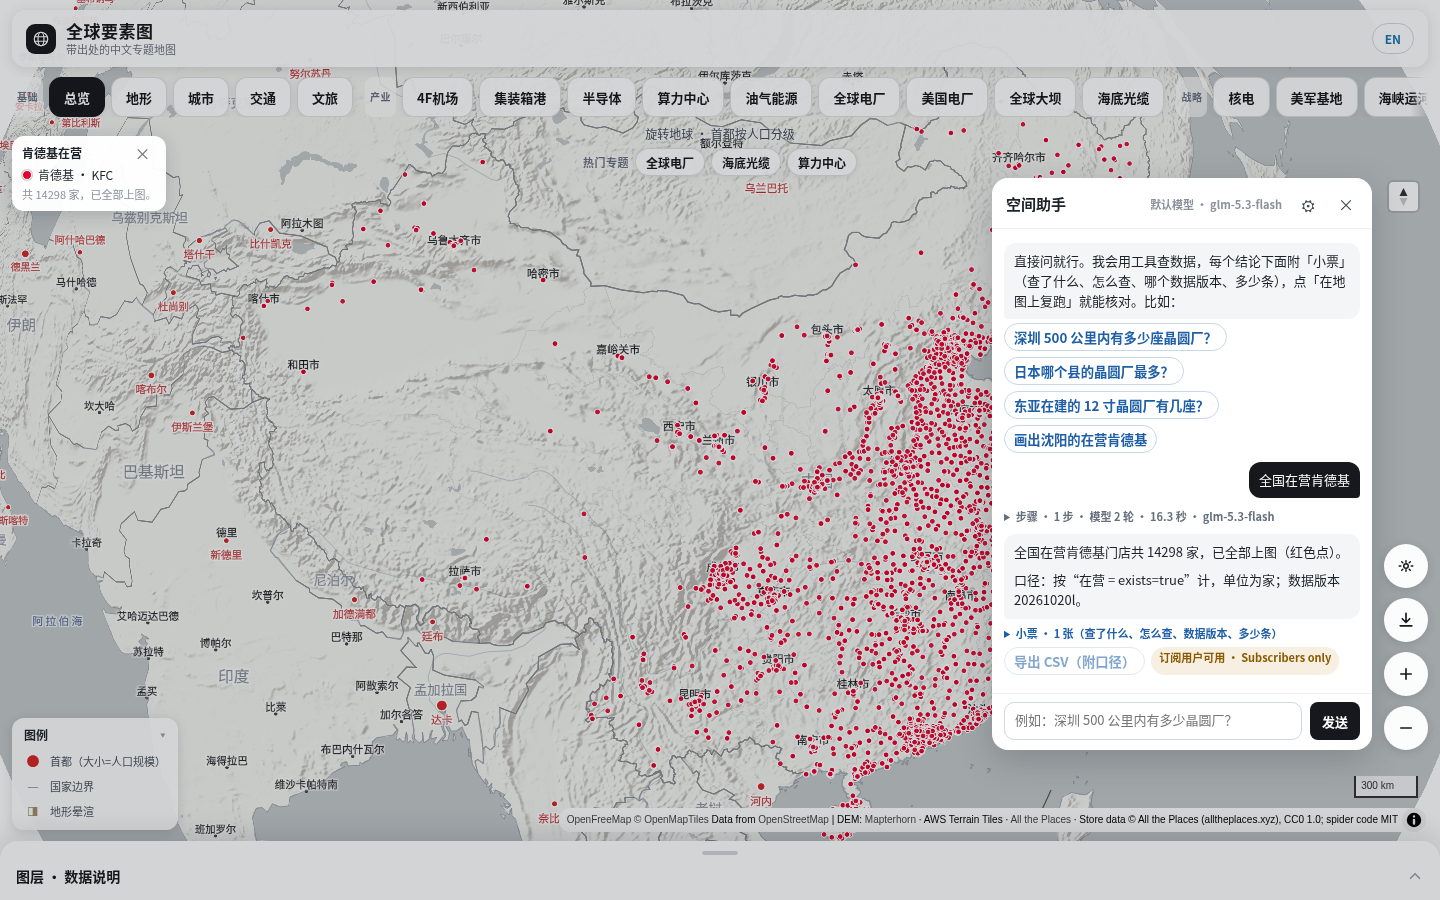
之所以不分页,是因为分页是为人眼设计的。如果每页只给模型二十条,它就要一页页往下翻,再自己相加,而相加恰恰是模型最容易出错的地方。给 AI 的接口,应当直接返回算好的总数和分组,再附上口径和版本。
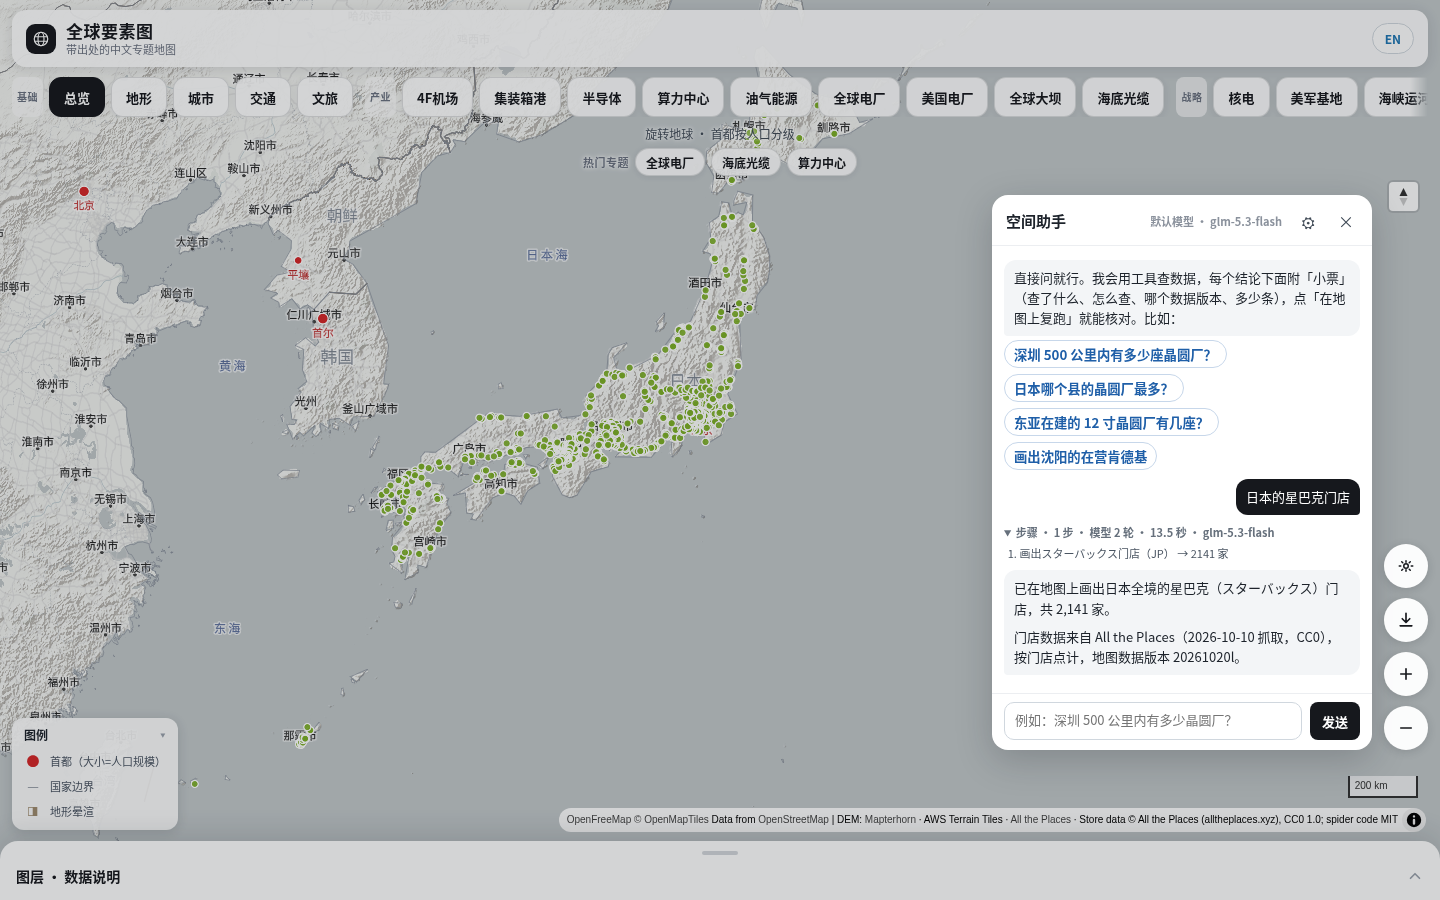
数据源一多,问题就更明显。问“日本的星巴克门店”,助手画出 2,141 家,并说明数据来自 All the Places 2026 年 10 月 10 日的抓取,采用 CC0 公共领域许可。这里有两件事是模型自己想不到的:日本的门店要去另一个数据源找;在那个数据源里,品牌登记的是日文店名。
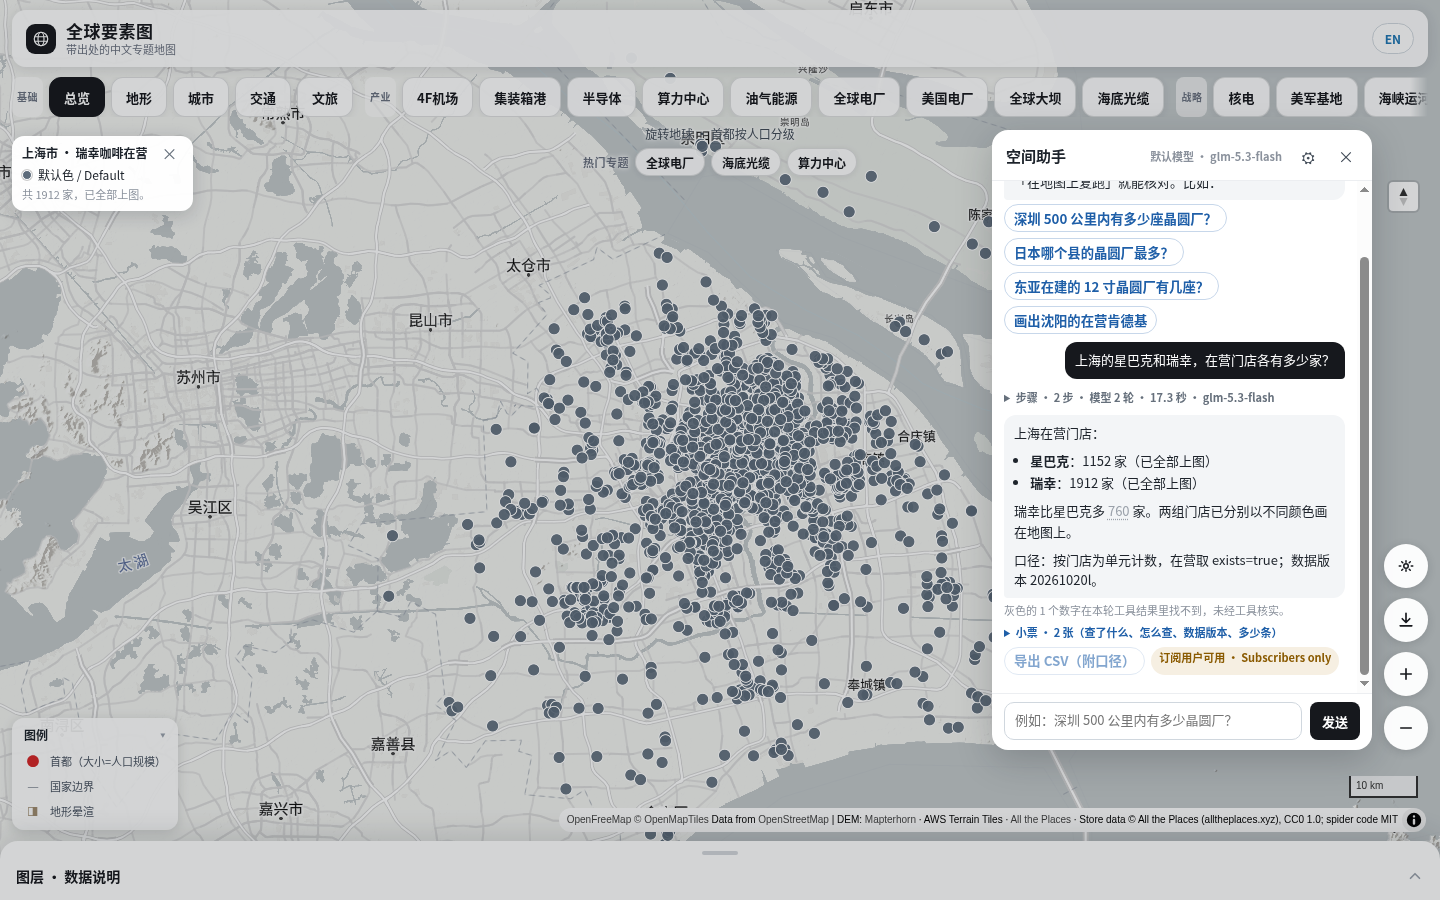
做选址的人更常问竞品。问“上海的星巴克和瑞幸,在营门店各有多少家”,助手分两次查询,给出 1152 家和 1912 家,各附一张小票。回答里还有一句“瑞幸比星巴克多 760 家”,760 被标成了灰色。这道减法没有算错,但这个数是模型自己算的,没有经过工具,所以照样标灰。
这种严格看起来有些较真。可在企业里,一个数字一旦写进汇报材料,就很难再追问它是怎么来的。宁可多标一个灰,也不让来源不明的数字混进去。
让助手知道自己不知道什么
一个能用的助手,必须知道自己的边界。
问“沈阳哪个区的在营肯德基最多”,助手说门店数据目前没有按区县分组统计的工具,答不了,并给出两个替代办法:放大地图看分布,或者逐区分别查询。问“肯德基去年在中国的营收是多少”,它说自己没有财务数据,建议查阅百胜中国的财报。
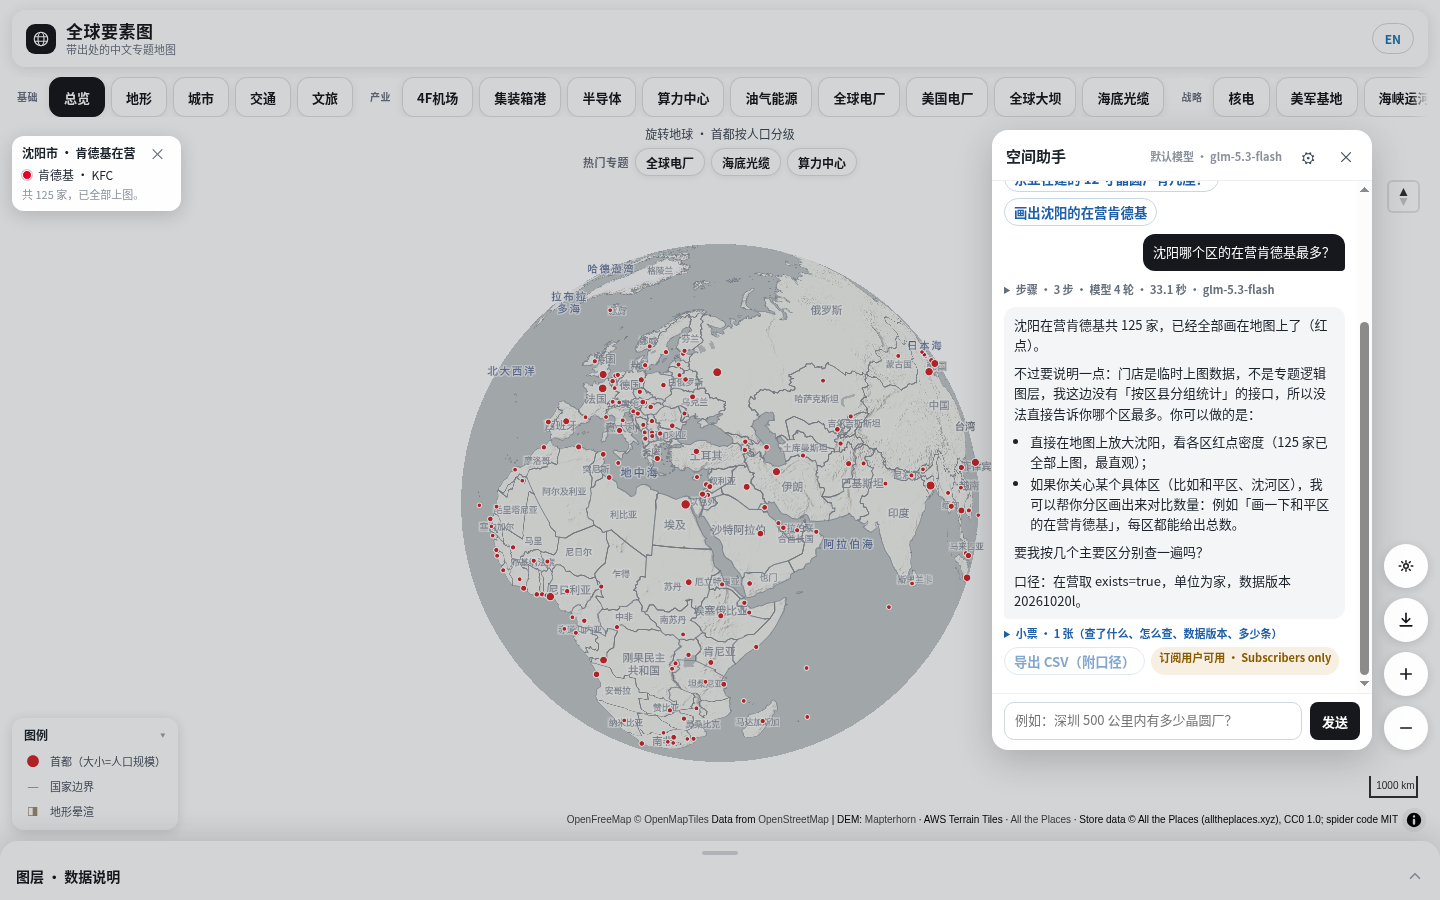
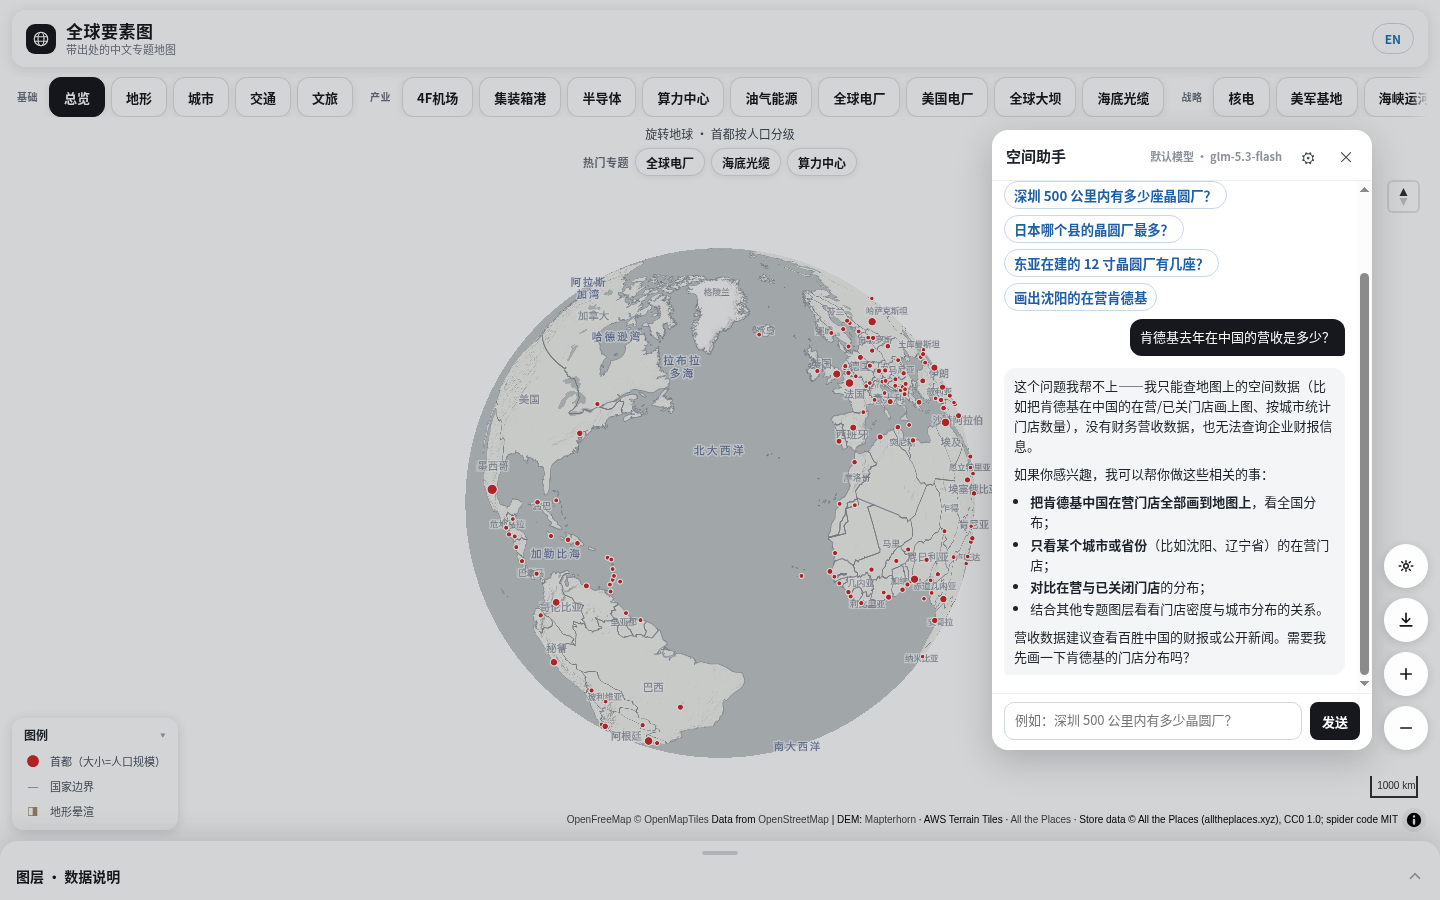
这两个回答是刻意设计的。助手能做什么,由工具清单决定;清单里没有的,就直说做不到,并告诉用户图上能做的相近操作。对企业来说,会说“做不到”的助手并不危险,危险的是凭记忆给出一个像模像样的营收数字,而它最后出现在领导的周报里。
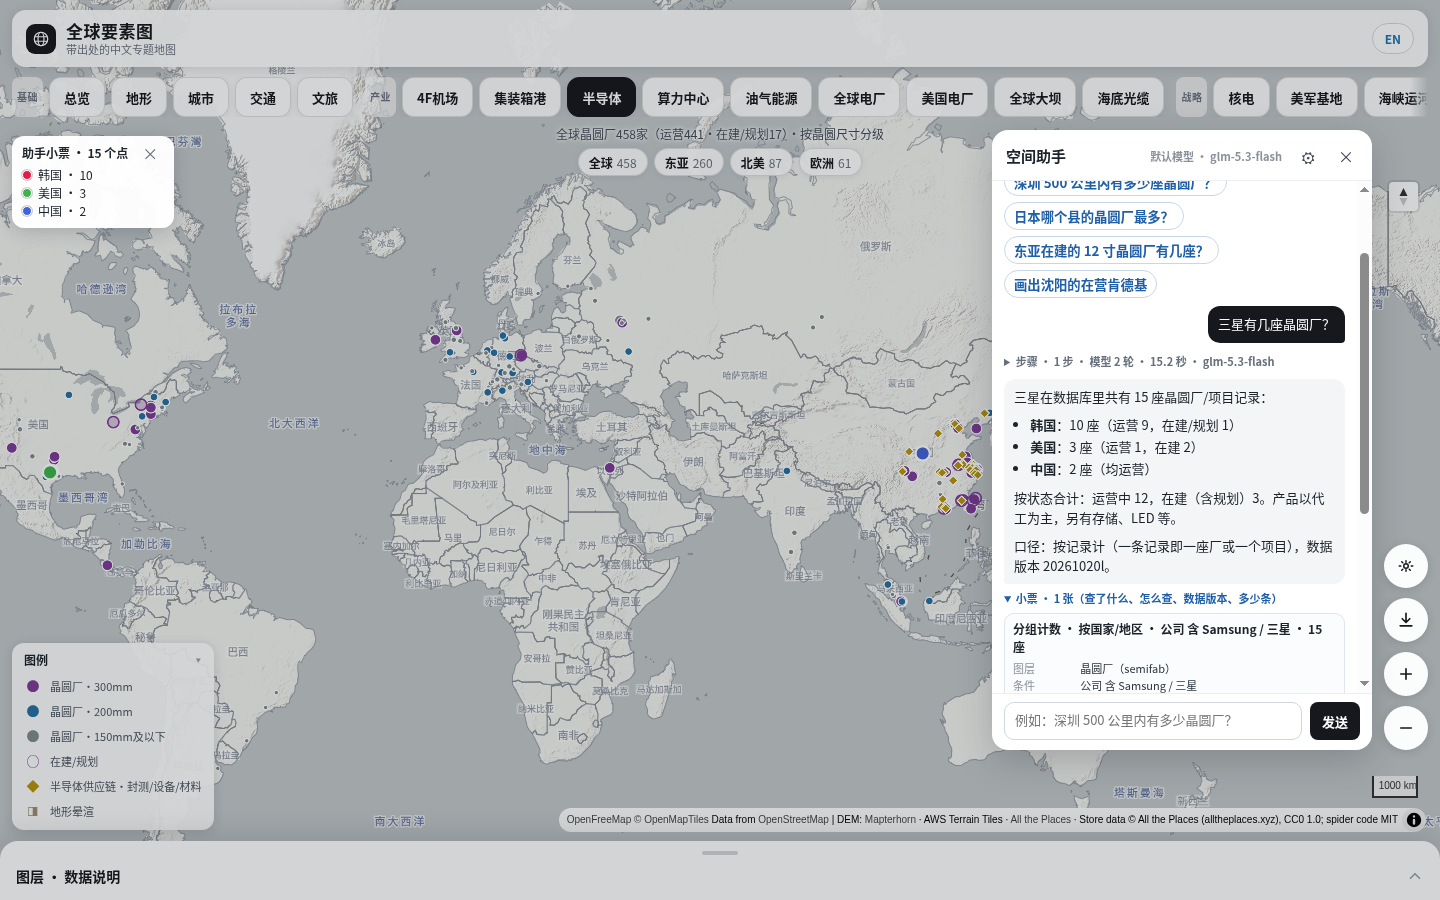
实体解析是另一道边界。问“三星有几座晶圆厂”,小票上写着查询条件是“公司名称包含 Samsung 或三星”。简称、英文名和法定全称要对到同一个主体;同名地名也要分得清,比如中国至少有四个地方叫“朝阳”。这部分我们还在打磨,原则是:候选不止一个时,把选择交给用户,不替用户选。
对企业意味着什么
如果你正在为公司规划这样一个助手,我的建议是,在选模型之前,先做几件事。
为每一层数据写一张数据卡:口径、字段含义、单位、版本、来源、覆盖范围、使用权限。“在营”怎么认定、日期字段代表什么,都写在这里;工具返回结果时,把与本次查询相关的那几条一并交给模型。
把计数、测距、范围、分组这些确定性计算放进工具,模型只负责选工具和组织语言。名称解析单独做:品牌、门店、商圈、地名,都先对到确定的实体。每个回答附一张可以复跑的小票。超出范围的问题,直接说做不到。
这些做法也有边界。全球要素图用的是公开数据和极海自己的数据;企业内部还有销售、租金、客流,各部门口径常常互相打架,权限也复杂得多,难度会成倍增加。助手能回答的是事实,比如有几家、在哪里、离多远;开不开店,仍然要由人来判断。 这个实验也刻意没有收集线上使用数据,所以我们还不知道真实用户最常问什么,这是下一步要补的功课。
极海过去十几年做的,主要是让人看懂数据;现在要做的,是让 AI 用对数据。以前,“开店日期是首次监测记录,不代表实际开业日”这句话写在网页说明里,分析师读一遍就记住了。现在,这句话要随每一次接口返回交到模型手上;模型转述时有没有把它带上,决定了领导拿到的那个数字能不能用。